互联网的垃圾堆里有什么?我让 AI 写了个爬虫,在 BT 网络里蹲了两天
DHT 和 Kad 我读过三遍,原理大概明白,但自己实现一套能跑的,光 bencode、KRPC、路由表、迭代查询就够几个晚上。现在不是有无敌的 AI 了么,我让它写。两天后拿到 4 万个 infohash、913 份元数据,这篇讲清楚它怎么工作,以及我在这个「无主网络」里看见了什么。
开始之前先叠个甲。
第一,这篇不放任何可用的资源链接。没有磁力链,没有 infohash 原文,没有索引站,所有文件名都打了码。
第二,我不提倡任何人去下盗版。这个爬虫只拿「名字」,一个字节的数据都没下——这件事后面会讲,技术上恰好能做到。
第三,数据量不大。两天、一台 2 核服务器、913 条样本。它的价值在于「看见了什么」,不在于「统计多精确」。
一、起因:原理我懂,但一直没动手
DHT 和 Kad 这一章,我前后读过三遍。
道理是懂的:没有中心服务器,几百万个节点自己维护一张表,还能在几跳之内找到任何一个资源。XOR 距离怎么算、路由表怎么分层、迭代查询为什么能收敛,纸上推一遍都不难。
但「看懂」和「能写出来」是两件事。
真要自己实现,得先把 bencode 编解码写了,再写 KRPC 的收发、路由表维护、迭代查询、超时重试,最后还要接 libtorrent 拉元数据。踏踏实实做,几个晚上跑不掉。
所以这件事一直在「想做的清单」里躺着,从来没开始过。
现在不是有无敌的 AI 了么。
我把想法跟它讲清楚:我要一个最简的 DHT 节点,能被动收 infohash,也能主动问节点要,然后把种子信息存下来——我不下载内容,只要名字。
剩下的我不用管。写代码、调协议、处理超时,它自己折腾。
我真正想看的只有一件事:这个 P2P 网络里到底流着什么数据。
二、DHT 到底解决了什么问题
先从最朴素的问题开始。
你在 BT 上点一个磁力链,客户端怎么知道该连谁?
早期是靠 tracker:一个中心服务器,所有人向它报到「我有这个文件」,想下载的人问它「谁有这个文件」。问题很明显——tracker 挂了,整个资源就废了;tracker 被查了,一批资源同时消失。
DHT 的思路是:把「谁有哪个文件」这件事本身,也变成可以分布式存储的数据。
做法是给每个东西算一个 160 位的 ID,然后按 ID 决定谁负责存它:
- 每个节点有自己的 node ID(随机生成,160 位)
- 每个种子有自己的 infohash(对种子信息做 SHA-1,也是 160 位)
- 规则是:infohash 和哪个节点的 ID「最接近」,就由那个节点负责记录「谁在下载这个种子」
于是「查询」就变成了「找离这个 ID 最近的节点」。没有中心,每个人只认识一小撮邻居,但合起来能覆盖整个 ID 空间。
三、Kad 的精髓:距离不是物理距离
「最接近」怎么定义?这是整个算法最有意思的地方。
不用经纬度,不用 IP 段,用的是 XOR 距离:
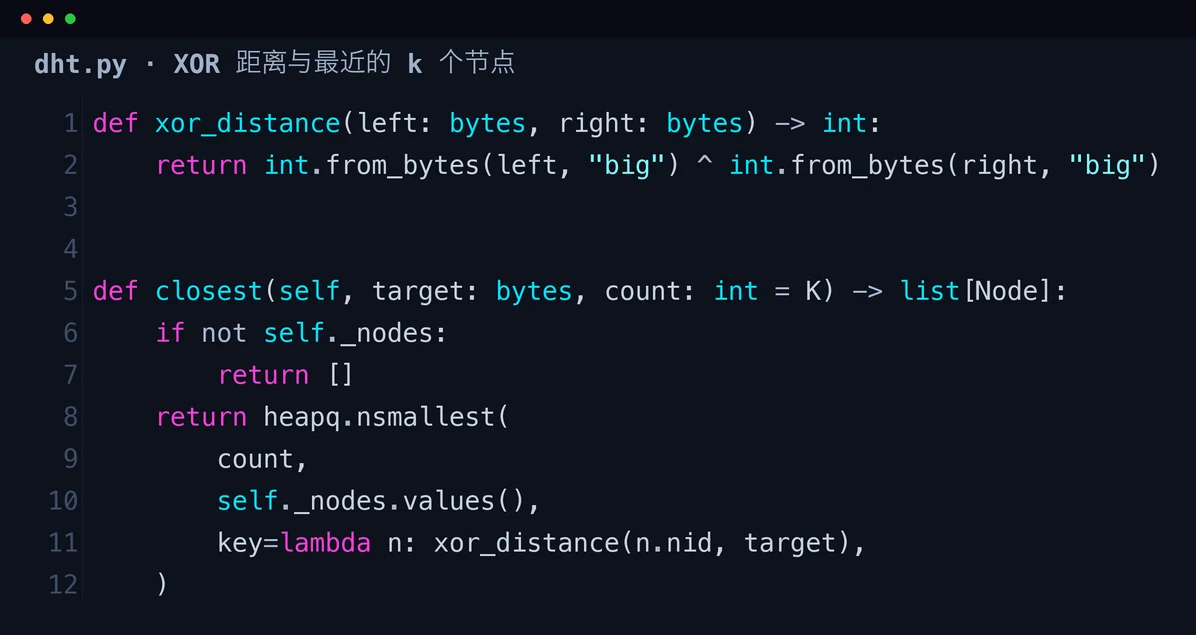
两行代码,但它满足三个数学性质:
一是对称。A 到 B 的距离等于 B 到 A 的距离,这跟真实网络里的延迟不一样,但正好符合「哈希空间」的语义。
二是三角不等式。A 到 C 的距离不超过 A 到 B 加 B 到 C。这条保证了「贪心查找」能收敛——你朝着目标走,每一步都不会绕远。
三是「高位决定远近」。两个 ID 异或之后,最高位的 1 出现在第几位,就说明它们在 ID 空间里隔了多远。第 159 位不同就是隔了半个空间,第 0 位不同就是挨着。这个性质让距离可以按「前缀」分层,天然适合做路由表。
标准 Kademlia 会用「k 桶」:把 ID 空间按前缀切成 160 个区间,每个区间留 8 个节点。它实现的时候偷了懒——直接维护一个扁平表,存最多 5 万个节点,查询时用 heapq.nsmallest 现算:
return heapq.nsmallest(count, self._nodes.values(),
                       key=lambda n: xor_distance(n.nid, target))
扁平表不是「标准实现」,但在嗅探场景下够用:不需要当一个「好公民」维持精确的 k 桶,只需要知道「哪些节点能应答我」。代码里它自己写了注释解释这个取舍——这一点我看了还挺满意,说明它没在照抄教程。
「最近」是相对的,不是绝对的。每个节点只认识自己附近的 8 个,问它「谁离目标最近」,它只能给出「我这几个邻居里最像的」。你拿着这个答案再去问下一批,一步步逼近。这就是「迭代查询」。
四、协议其实很简单:一个 UDP 端口 + 一套编码
DHT 跑在 UDP 上,端口 6881。消息用 bencode 编码——就是 BT 种子文件用的那个格式。
它的规则少得离谱,只有四种类型:
- 整数:
i42e - 字符串:
4:spam(长度 + 冒号 + 内容) - 列表:
l...e - 字典:
d...e,key 必须按字节序排好
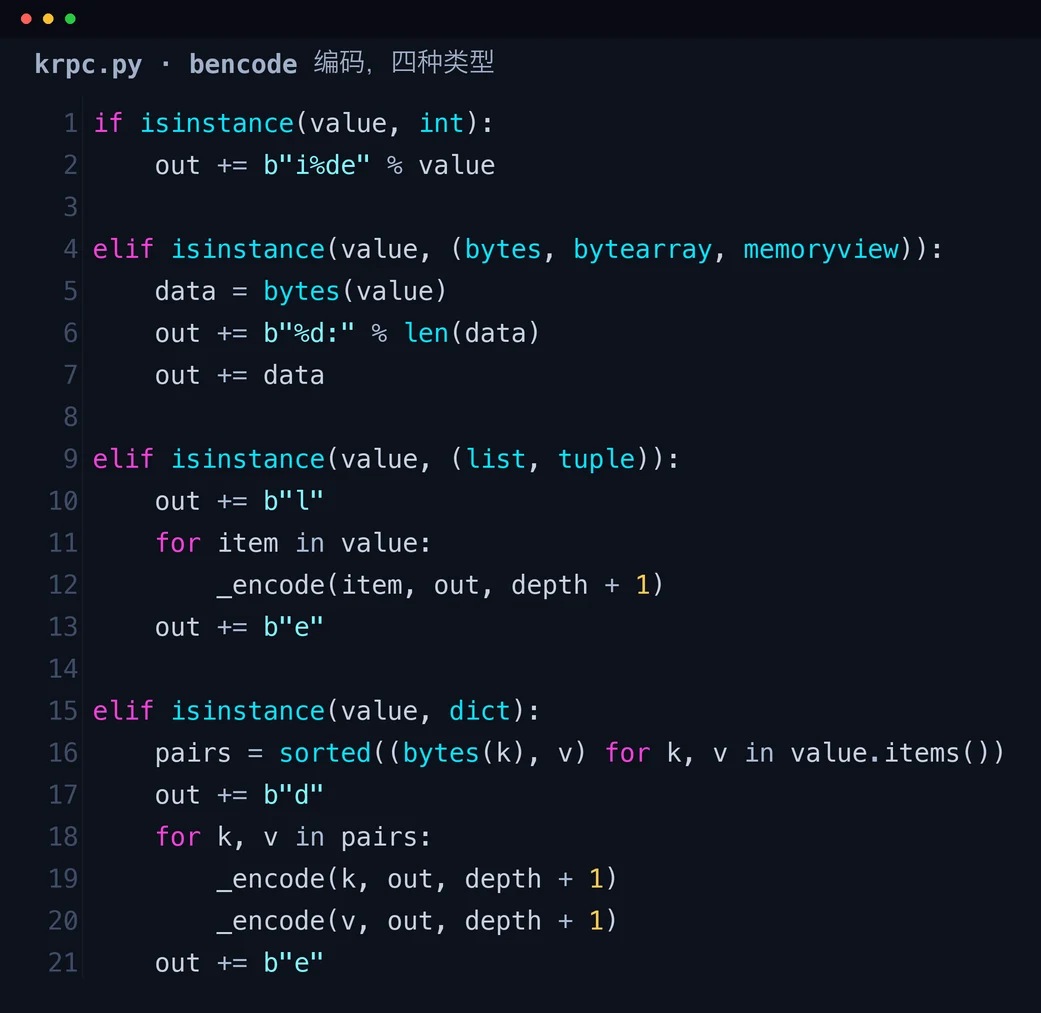
四种类型,六十行代码就能实现完整的编解码。字典要排序这一条是协议硬性要求,不排的话对面可能直接拒收。
在这套编码之上,只有四个方法:
| 方法 | 干什么 |
|---|---|
ping | 你还活着吗 |
find_node | 给我几个离目标近的节点 |
get_peers | 谁有某个 infohash |
announce_peer | 我有某个 infohash |
整个 Mainline DHT 就这么点东西。协议简单到可以手写,这是它能活二十年的原因之一。
五、让 AI 把节点造出来
启动只需要连上几个种子节点(router.bittorrent.com 这类),发一个 find_node,对面就会回你 8 个节点。再问这 8 个,再问它们的邻居……几十秒内路由表就有几百个节点了。
然后就是「等」。
节点会应答所有找上门的请求:ping 回 pong,find_node 回 8 个最近的节点,get_peers 回一组节点加一个 token。
关键在这一步:别人来问 get_peers 的时候,请求里带着一个 info_hash。这就是他正在找的资源。不用回答他,光把这个 hash 记下来,就白捡一条数据。
这叫被动监听。理论上很美好——你什么都不用做,全世界都在给你送数据。
实际跑了两天,我发现这个想法太天真。
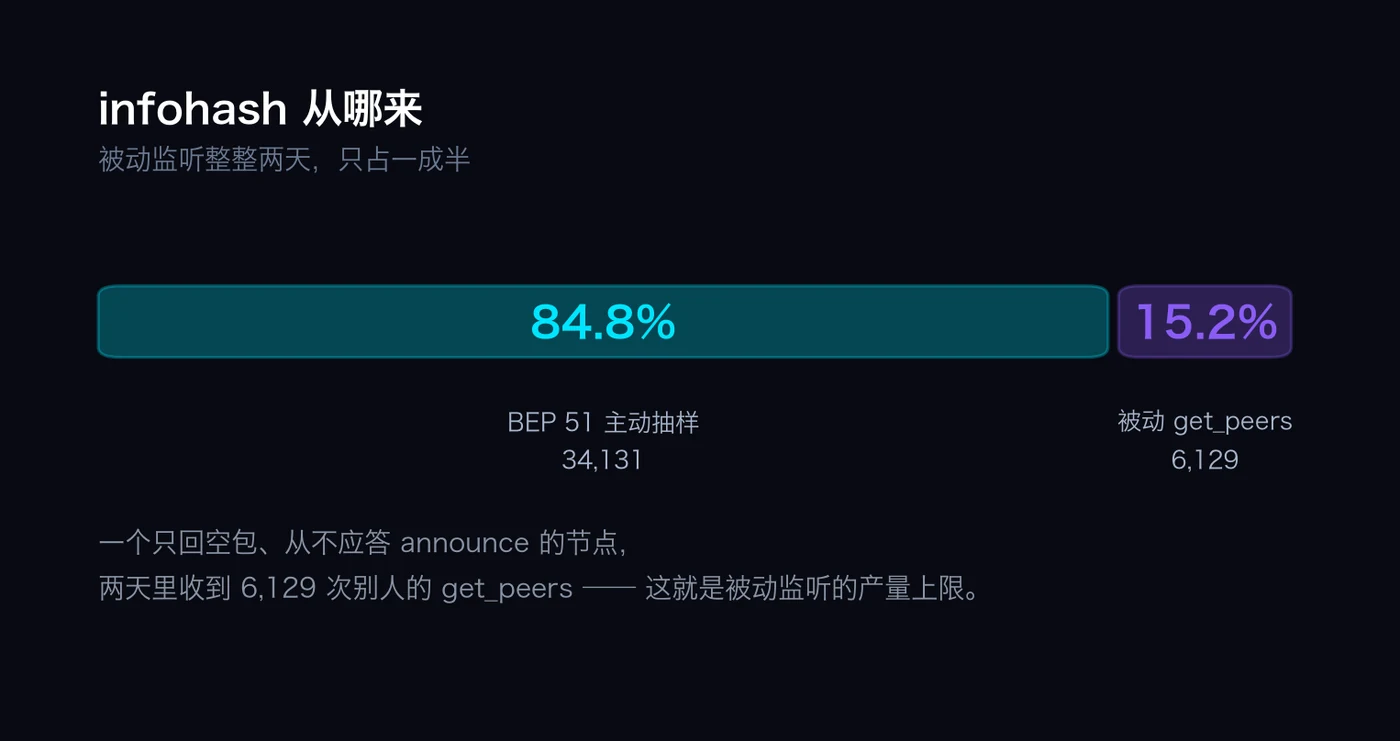
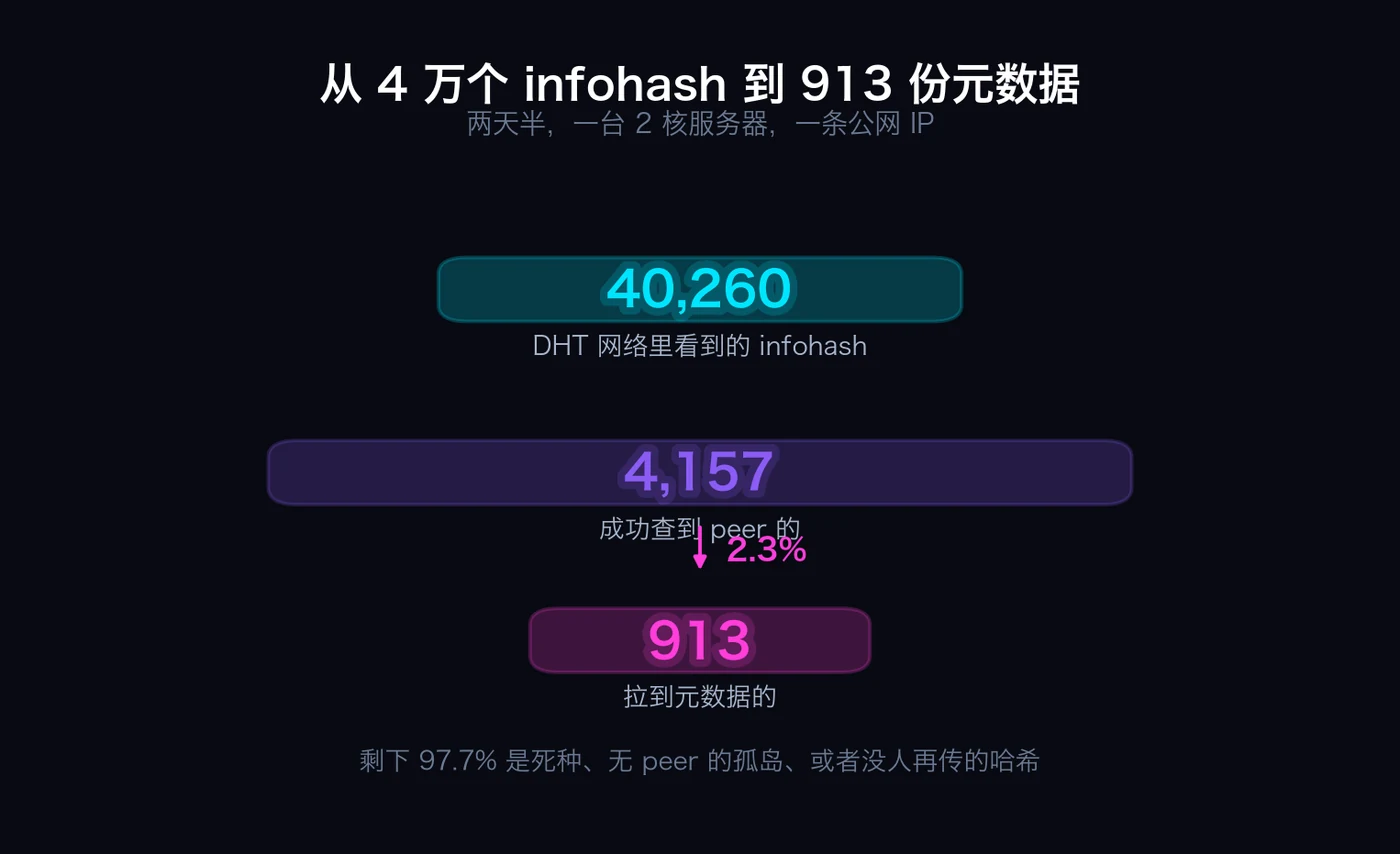
40,260 个 infohash 里,只有 6,129 个(15.2%)来自被动监听。剩下 84.8% 全部来自一个我原本没打算重点做的功能:BEP 51 主动抽样。
道理也很简单:一个刚上线两天的新节点,在整个网络里几乎不存在。别人找资源根本轮不到问你,所以你收到的请求少得可怜。
这一点跟我预想的反了。我原以为「蹲着就能收」,实际是「得主动去要」。
六、BEP 51:直接问节点「你存了什么」
BEP 51 是 2016 年加进协议的扩展,思路非常直白:节点既然负责存一批 infohash,那就干脆让它报一份样本出来。
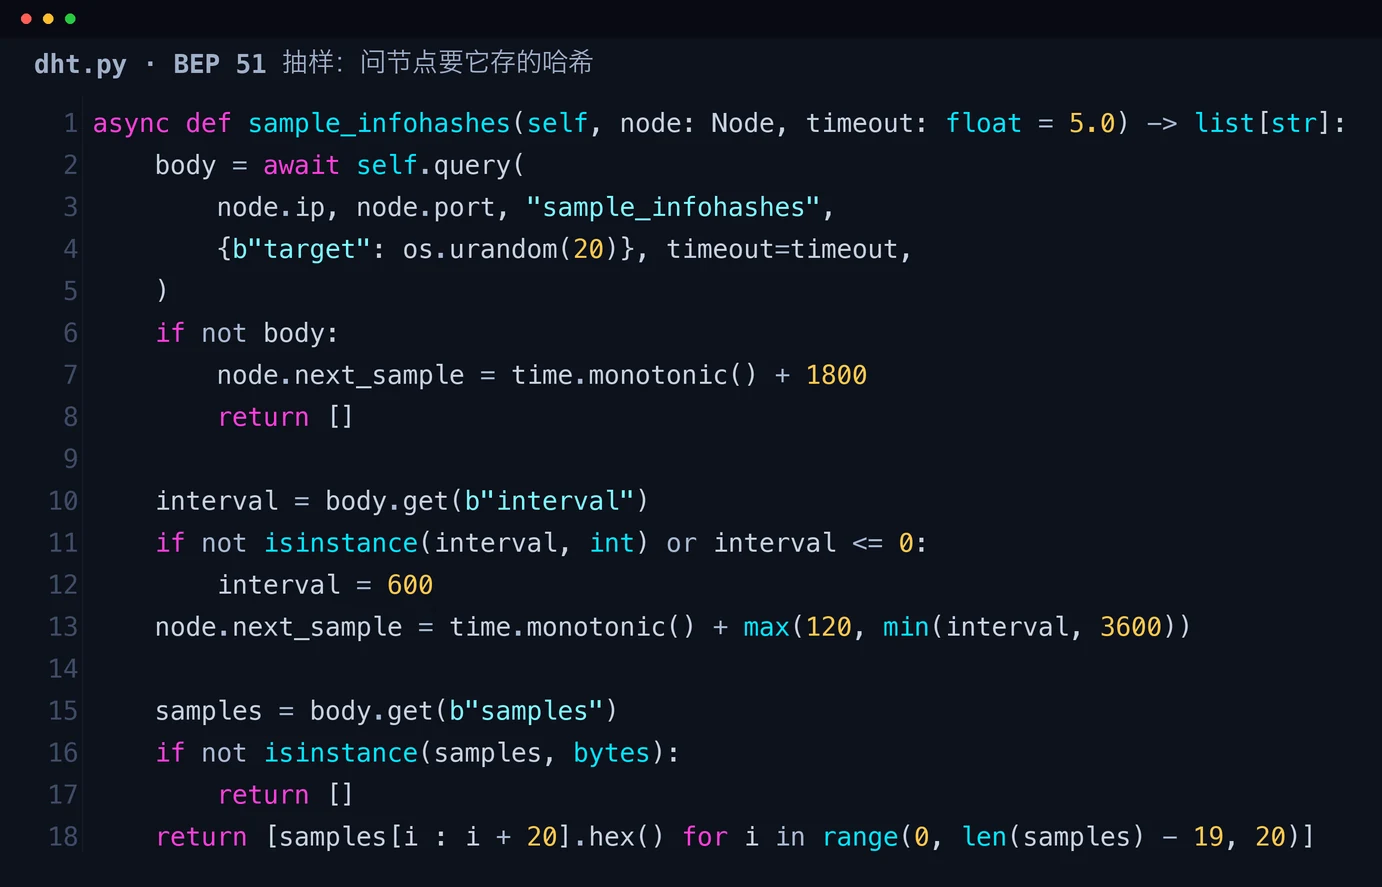
发一个 sample_infohashes,把节点存的哈希按 20 字节一个切出来,一次能拿几十到几百个。
这里有个细节:节点返回的 interval 是「你隔多久再来问」,它做了个上下限保护(最少 120 秒,最多 3600 秒),免得把人家问烦了直接拉黑。这种地方最能看出 AI 有没有真的理解协议——照抄教程的代码不会考虑这个。
拿到之后还有一步:这些只是 hash,没有名字。要知道它是什么,得去查「谁有它」(get_peers),再连上去问「你能把种子信息给我吗」(BEP 9 元数据交换)。
这就是那个 2.3% 的漏斗。
七、只要名字,不要内容
这一步是 AI 自己加的,我一开始没想到。
我提的需求很粗:「只拿元数据,别下文件」。我以为这会很麻烦——得在下载逻辑里加判断,或者下完再删,还担心删不干净。
结果它改了三行:
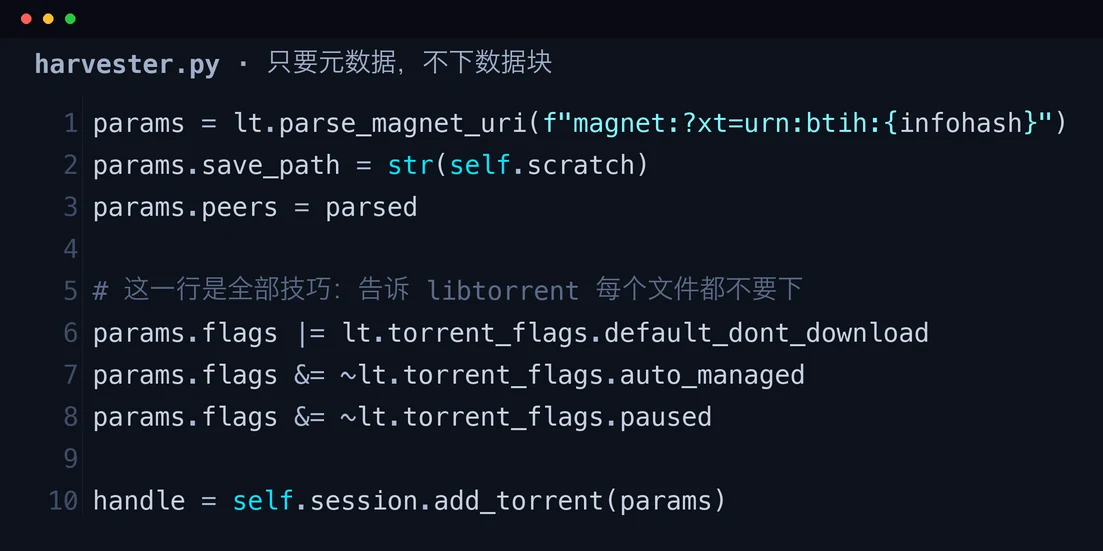
libtorrent 有个 flag 叫 default_dont_download:
params.flags |= lt.torrent_flags.default_dont_download
设上它,客户端会正常握手、正常交换元数据,然后——对每一个文件都「跳过」。
结果就是:能拿到完整的种子信息(文件名、文件列表、每个文件多大、分块哈希),但硬盘上一个字节的数据都不会落地。
一行。就这一行。
我不是在「下载」,我是在「读目录」。这个区别在技术上很清晰,在伦理上也很清晰——手上没有任何一个文件的内容,只有一份份写着名字的清单。
顺便说,这也是为什么存储成本极低:913 个种子加起来 6.85 TB 的声明容量,实际入库的数据库只有 57 MB。
八、两天,到底看见了什么
服务器上跑了两天(10 月 21 日 18:44 到 23 日 23:08,约 52 小时),配置是每秒最多 10 个 UDP 查询、20 个种子并发抓取。
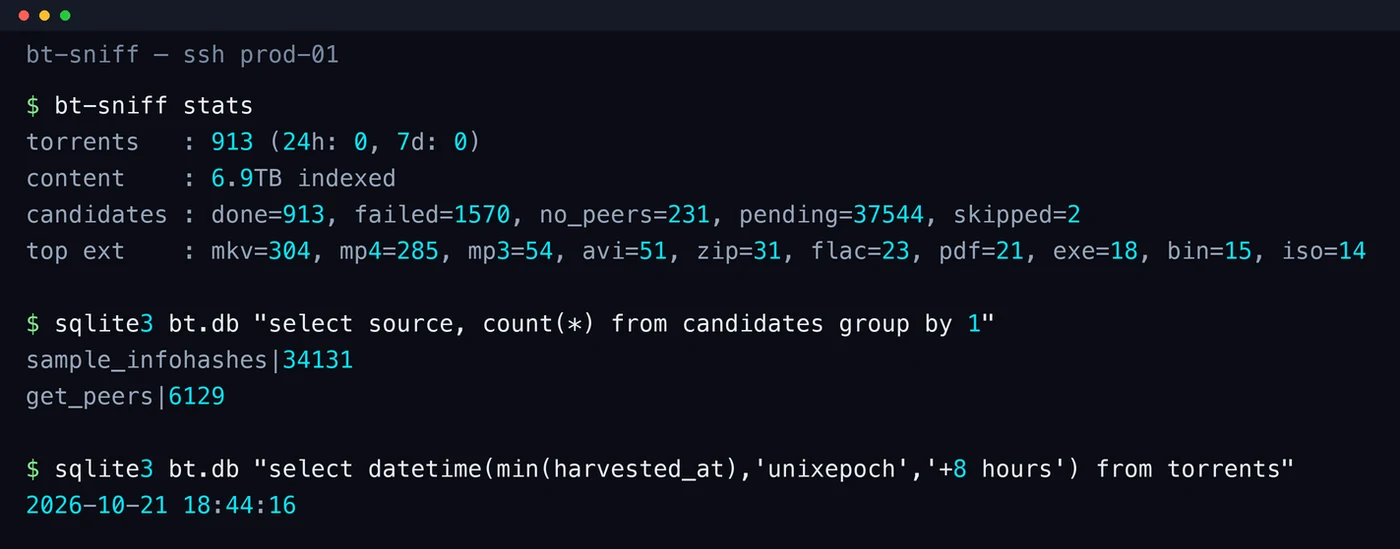
几个数字先说清楚:
| 指标 | 数值 |
|---|---|
| 见过的 infohash | 40,260 |
| 成功查到 peer | 4,157 |
| 拿到元数据 | 913 |
| 声明总容量 | 6.85 TB |
| 平均单个种子 | 7.9 GB |
| 最大的一个 | 1.78 TB |
| 队列里还压着 | 37,544 |
最大的那个 1.78 TB,平均 7.9 GB。这两个数字说明这个网络里的「大东西」是真的很大。
队列压着 3.7 万个没处理,这个更值得说。我配的上限是每天 5000 个,两天理论上能处理 1 万次尝试,实际只处理了 2714 个(913 成功 + 1570 失败 + 231 找不到 peer)。
瓶颈不在拉元数据,在找 peer。每个 infohash 要先做一次迭代查询,问一圈节点「谁有它」,配置里这一步并发只有 8、超时 15 秒。这一步慢了,后面全都堵着。
九、垃圾堆的构成
现在说到正题。
913 个种子,按扩展名分类:
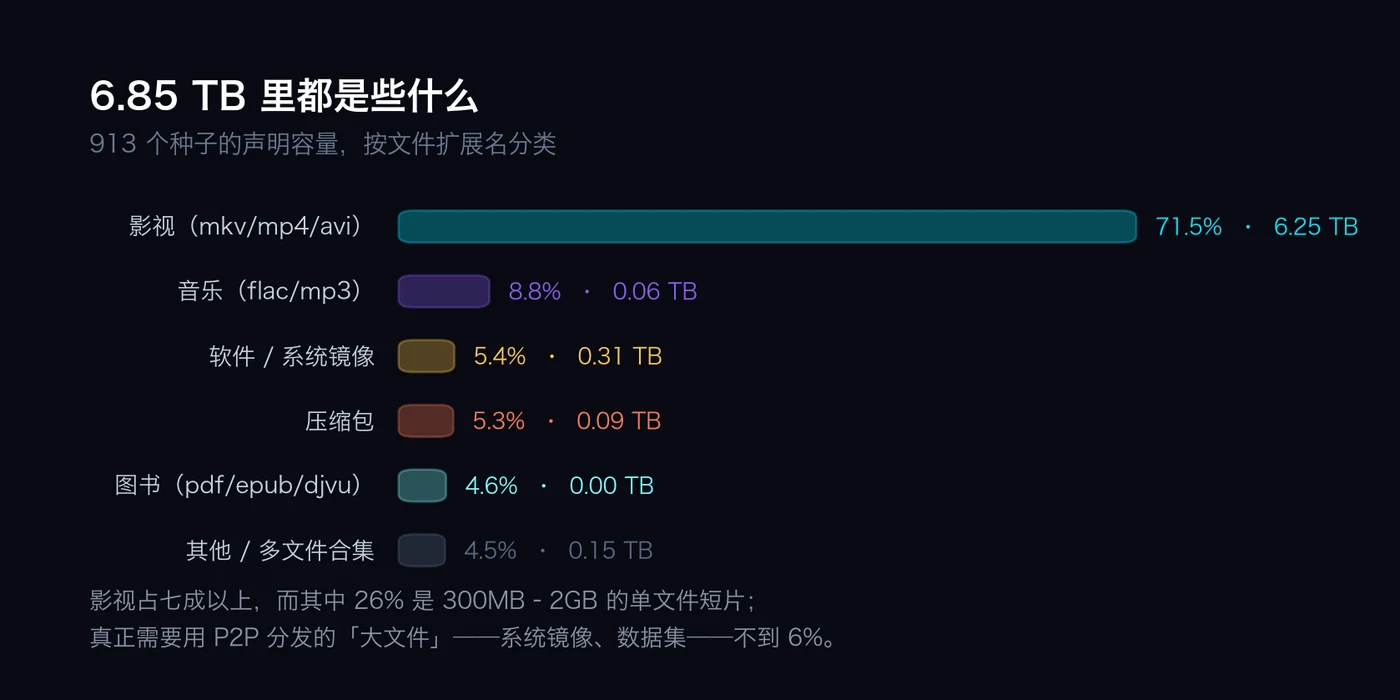
影视占 71.5%,6.25 TB。mkv 304 个、mp4 285 个、avi 51 个。
音乐 8.8%、软件镜像 5.4%、压缩包 5.3%、图书 4.6%。
真正「需要用 P2P 分发的大文件」——系统镜像、数据集、开源软件——加起来不到 6%。
这跟 BT 最初的设计意图是反的。BT 诞生的时候,要解决的是「一个大文件,很多人要下,源站带宽扛不住」。Linux 发行版、开源项目的 ISO、科研数据集,这才是它的用武之地。
而现在,这个网络 94% 的流量指向的是别的东西。
再看体积分布和语种:
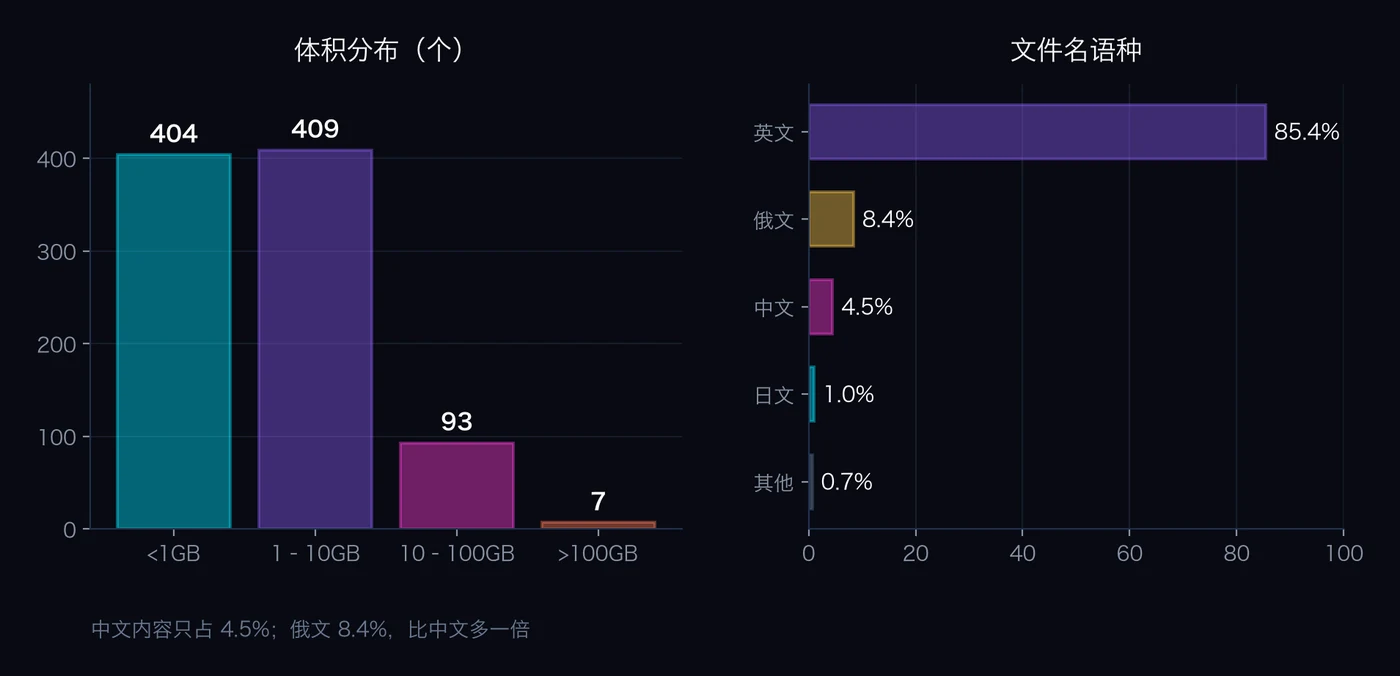
两个细节很说明问题。
一是 404 个种子小于 1 GB。大文件分发不是主流,「小东西」才是。
二是 中文只有 4.5%,俄文 8.4%。俄语内容比中文多一倍。这跟 BT 在俄语区的使用习惯有关,也说明这个网络的重心不在中文互联网。
十、名字里的信息量
还有一个我觉得最能说明「垃圾堆」性质的角度:这些资源的名字,能读懂多少。
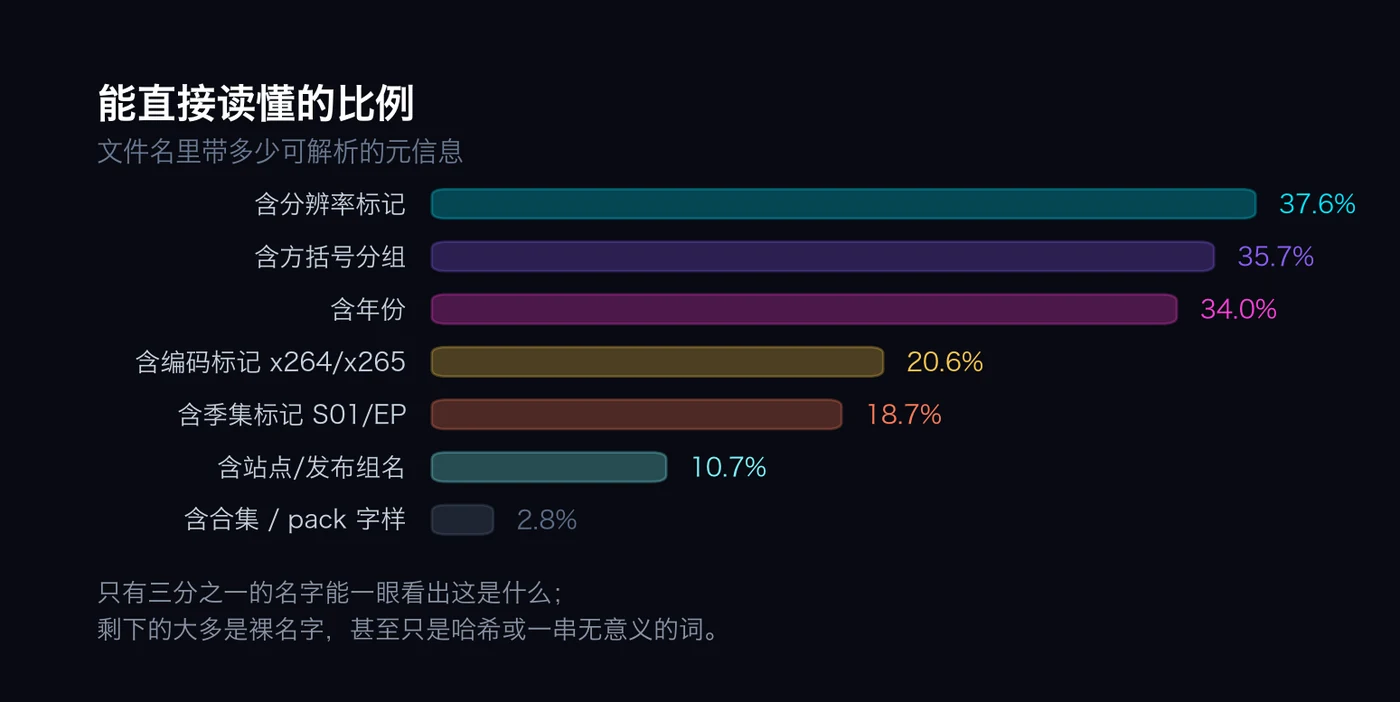
带分辨率的 37.6%,带方括号分组的 35.7%,带年份的 34%。
也就是说,只有三分之一的名字能让你一眼看出这是什么。
剩下三分之二是什么样?我把名字涂掉,只留结构给你看:
████████ ████████ ███ (2019) 1080p x264 ████      ← 这条看得懂
██████ ██████████ 780MB                            ← 这条只能靠猜
████ ██████ ████ ██                                ← 这条完全不知道是什么
第一行是正常影视资源的命名规范:标题、年份、分辨率、编码、发布组。
第二行只有名字和大小,没有年份、没有分辨率。你要么下下来看,要么去搜。
第三行连名字都不像名字,就是一串词。
这就是「垃圾堆」最准确的描述:东西本身未必烂,关键是没有任何索引。
一个正常的资源站会给你分类、标签、封面、简介、评分。DHT 里什么都没有,只有一串哈希和一个人随手起的名字。你得先把它变成「可检索的」,才知道里面有没有你要的。
我自己在数据库里搜「ubuntu」「debian」「arch」这种词,能找到一些。搜「论文」「数据集」,几乎什么都搜不到。
十一、那 6.7%,和它低估的部分
到这里必须说一句实话。
我在文件名里搜「明确标记类目」的关键词,命中 61 条,占 6.7%。
但这个数字严重低估。因为大量资源的名字是「裸的」——不带任何标记,只有一串词。真正按内容分,比例远高于这个数。
我不打算在这里展开。原因很简单:这篇文章的目的是讲清楚这个网络是怎么工作的,不是教你从这里找什么。具体类目我不描述、不举例、不打擦边球。
我能说的是:我人工翻了大概两百条,其中相当一部分,看一眼名字就知道不该出现在任何正经场合。这也是我最后没有继续跑下去的原因之一——数据是干净的(只有名字),但看多了不舒服。
十二、BT 真正的价值还在不在
说了这么多垃圾,得把话说公道。
BT 在它该干的活上,依然是无可替代的。
我自己的服务器装系统,用的还是 Debian 的 ISO。官方源站带宽有限,用 BT 下反而更快,而且源站不用承担全部流量——这正是 BitTorrent 设计的初衷,而且它做得非常好。
几个真实的好处:
- 抗峰值。一个发行版发新版,几万人同时下。HTTP 源站会崩,BT 不会,人越多越快。
- 抗单点故障。没有 tracker 也能跑(DHT + PEX),源站挂了老种子还能活。
- 带宽成本转移。下载者同时也是上传者,源站只出「一份」。
这套机制本身没有问题。问题在于,同一个机制既能分发 Debian,也能分发别的东西,而且后者更容易传播——门槛低、需求大、没有正规渠道。
这就是「垃圾堆」的来源:技术本身是中性的,它没法区分装进去的是什么。
十三、所以,垃圾堆里能找什么
回到标题那个问题。
能找什么?
技术上,能找到任何「有人还在传」的东西。但实际能用的,只有一小撮:
- 开源软件的镜像和安装包。Linux 发行版、大型开发工具,这部分质量最高、命名最规范。
- 已过版权期的影音和书籍。古典音乐、老电影、公版书,有但不多。
- 数据集和学术资源。极少,因为这类东西通常有正规渠道。
- 剩下的绝大部分,是你不需要的。
找不到什么?
找不到「你想要的某个具体东西」。因为这个网络没有搜索引擎,只有哈希。你得先知道哈希,才能找;而哈希从哪来,又回到索引站和论坛去了。
所以 DHT 从来不是「找东西的地方」,它是「找到之后用来下载的地方」。这个区别很多人搞混。
十四、这次折腾,我到底得到了什么
代码是 AI 写的,但盯着它写的过程,我确认了三件原本只是「知道」的事。
第一,简单协议能活很久,复杂度不在协议里。
bencode 四种类型、KRPC 四个方法,二十年没大改,撑起了全球最大的 P2P 网络之一。真正难的地方不在设计,在规模和对抗——怎么在几百万个不可信节点里维持一张能用的表,怎么防止有人灌垃圾 ID 进来。这些才是工程量所在。
第二,无中心的代价是「没人负责」。
没有中心就没有索引、没有分类、没有审核、没有删除。所有「中心」能提供的东西,都得靠外部补。这不是实现问题,是架构的固有代价——它取消了守门人,也就取消了整理者。
而「整理」恰恰是中心化平台唯一真正不可替代的价值。
第三,AI 比我更熟悉「标准实现」。
我想到的是「怎么把 k 桶写对」,它想到的是「这个场景根本不需要 k 桶」。我没想到 default_dont_download,它直接用了。这说明一件事:对于有明确规范的老协议,AI 的收益主要在「知道有哪些轮子」,而不是「发明新东西」。
这部分认知,比我原计划的「验证 Kad 理解」有用得多。
至于那个爬虫,跑了两天我就停了。数据库 57 MB,留在服务器上,偶尔用来看看「今天又有什么新东西」。
大部分时候,答案是「没什么新东西」。
附:如果你想自己试
前面那些代码片段都是从完整实现里挑出来的,整份代码我放进了开源仓库 youerning/blog 的 btsniff/ 目录——近 1900 行 Python,带 pyproject.toml、uv.lock 和 systemd 单元文件,uv sync 之后 uv run bt-sniff run 就能跑起来。本文的配图和数据也在那个目录的 img/ 里。
技术上不复杂,让 AI 一晚上能写出来。几个关键点:
- 用 Python + asyncio。UDP 收发包天然适合协程,一个端口就是一个节点。
- bencode 自己写,别找库。六十行,写完就理解协议了。
- 路由表可以先扁平。标准 k 桶是给「长期当节点」用的,嗅探只需要「能问到人」。
- BEP 51 是产量主力,别指望被动监听。新节点没人问你。
default_dont_download一定要设,否则它会真的开始下文件。- 加限速和上限。我配的是每秒 10 个查询、每天最多 5000 个种子——不是技术限制,是不想给网络添乱。
- 别用家用宽带跑。UDP 6881 长期开着,你的 IP 会进别人的路由表,也可能被运营商盯上。
最后一句:这套东西的价值在于「看懂」,不在于「获取」。
看懂之后你会发现,互联网的垃圾堆之所以是垃圾堆,不是因为里面没有好东西,而是因为没有人负责整理。
参考链接
- BEP 5: DHT Protocol——DHT 与 KRPC 的规范全文,四个方法和 XOR 距离都在这里定义,全文不到十页
- BEP 9: Extension for Peers to Send Metadata Files——只交换 info dict、不传数据块的机制,本文「只拿名字不拿内容」的依据
- BEP 51: DHT Infohash Indexing——
sample_infohashes扩展,我这边 84.8% 的产量来自它 - BEP 3: The BitTorrent Protocol Specification——bencode 的四种类型定义在这一节,写编解码前先看它
- Kademlia: A Peer-to-peer Information System Based on the XOR Metric——Maymounkov & Mazières, 2002。XOR 距离和路由表的原始论文,那三条性质就是从这来的
- libtorrent 参考文档——
torrent_flags那一套 flag 的定义,default_dont_download在这里 - libtorrent DHT 扩展——客户端侧怎么实现
sample_infohashes
(bittorrent.org 在国内有时连不上,挂个代理就行。)
本文所有数据来自 2026 年 10 月 21–23 日的实测,样本 913 条。文中不包含任何资源链接、infohash 原文或可识别的文件名。
