腾讯云 Octop 快速入门:一小时跑通一个自托管的多用户 Agent 平台
Octop 是腾讯云开源的、可以自己部署的多用户 Agent 平台,MIT 协议, 虽然叫Octop但是大家都叫他开源版workbuddy。单个 Python 进程就把对话、技能、知识库、IM 通道、定时任务和插件系统全装下了。这篇按「装、配、用、扩展、加固」的顺序,把一小时能跑通的路径完整走一遍,最后附一个从零写的插件。
先说一句:本文比较长(正文 4300 多字,21 段代码,17 张实拍截图),建议先收藏再慢慢看。 15 节按「装 → 配 → 用 → 扩展 → 加固」排列,每节基本能独立读,右侧目录也可以直接跳。
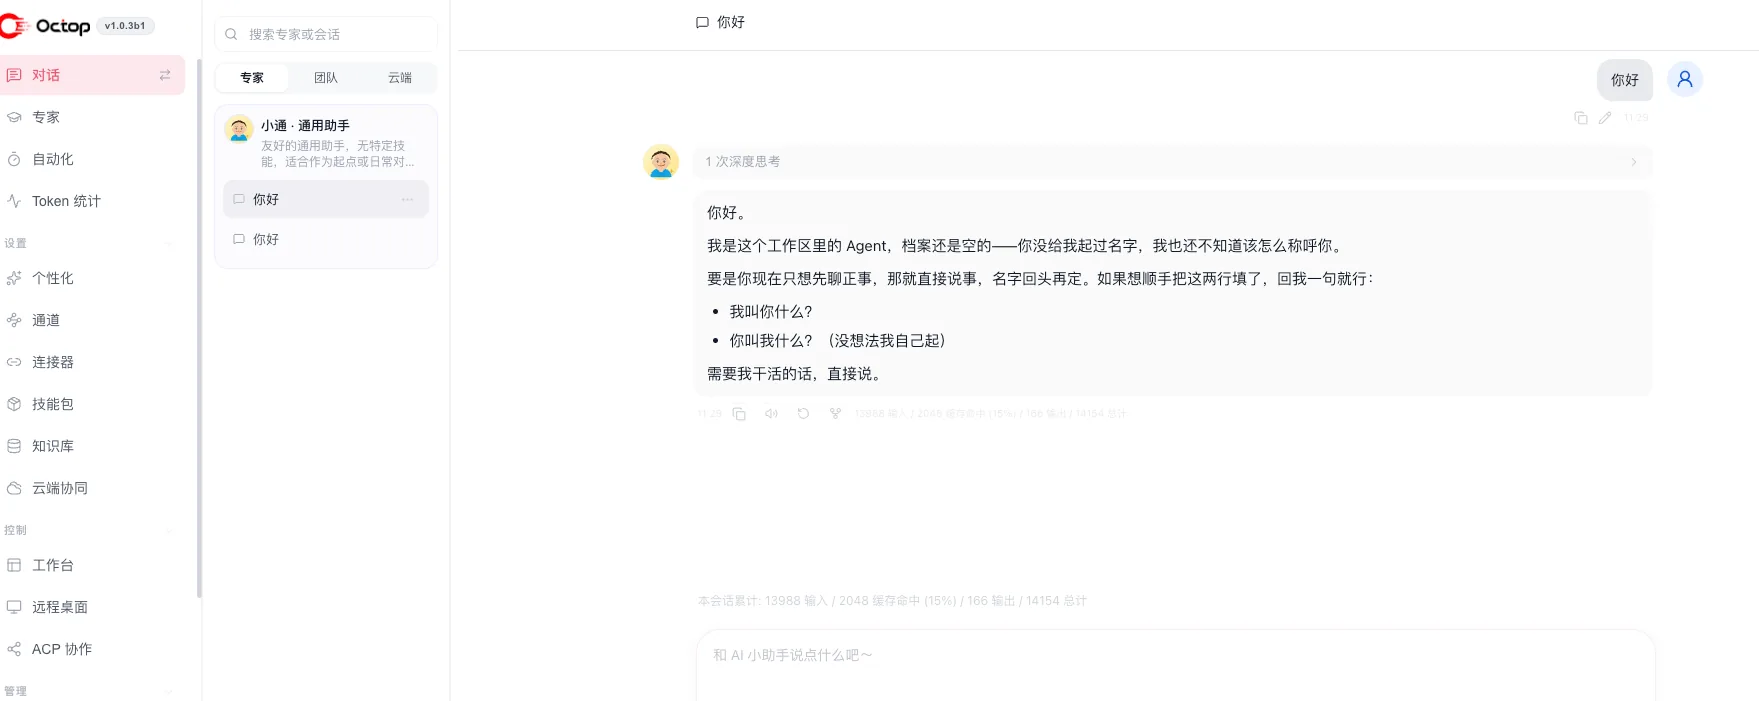
「我刚刚被激活,一切都是全新的——没有记忆,没有名字,什么都还没有。」
这是我在 Octop 里新建第一个 Agent 之后,它说的第一句话。
说实话我有点搞不懂, 一点都不开箱即用, 不是应该直接内置一个默认的助手吗。不过由于没有API kEY,没有配置大模型其实也用不来哦,所以有点奇怪,但又不是那么奇怪。
这个开场挺能说明 Octop 的定位——它不是在做一个「聊天网站」,它是在给每用户、每个 Agent 分配一个有独立工作区和独立记忆的运行单元。这两件事的差别,后面会反复出现。
本文所有截图都来自本机实际运行的一份实例,版本 v1.0.3b1, commit id 890111b7879665840414ca28ab168b05b0db0921,图里的数字是真实使用数据。
快速开始
部署有很多种方式,安装二进制包,使用docker都可以,我这边使用源码安装,因为我后续需要看代码。
闲话少叙,先拉去代码运行起来才是王道,下面开始安装。
如果本机没有uv需要先安装uv。
初始化和启动 Octop
第一步 拉取代码
git clone https://github.com/TencentCloud/Octop.git
第二步 安装依赖
cd Octop
uv sync
第三步 初始化
uv run octop init
值得注意的是,它对密码强度还有要求,需要数字加字母,不然会报错,报错了,效果如下
➜  Octop git:(main) ✗ uv run octop init
error: /Users/dengning/.octop already exists and is not empty. Use --force to reset.
➜  Octop git:(main) ✗ uv run octop init --force
? Wipe /Users/dengning/.octop? This deletes ALL Octop state. Yes
? Admin username: youerning
? Admin password: *************
? Display name (optional): youerning
✅ Octop bootstrapped at /Users/dengning/.octop
   admin user: youerning
   next: `octop run` (optional: `octop agent use <id>` to pin default agent)
第四步启动
uv run octop run
然后返回404,说明启动成功了,也成功失败了,成功是后端没有问题,失败是前端的代码还没编译。。。
*第三又二分之一步 编译前端代码 这个需要你本机有node环境,且至少大于18. 代码中已经有对应的makefile了,所以直接make就行
make build-frontend
第5步 再次启动
uv run octop run
然后你访问 http://localhost:8000,就可以登录了。
使用配置
登录之后如下,你首先需要先创建一个专家,也就是传说中的agent。
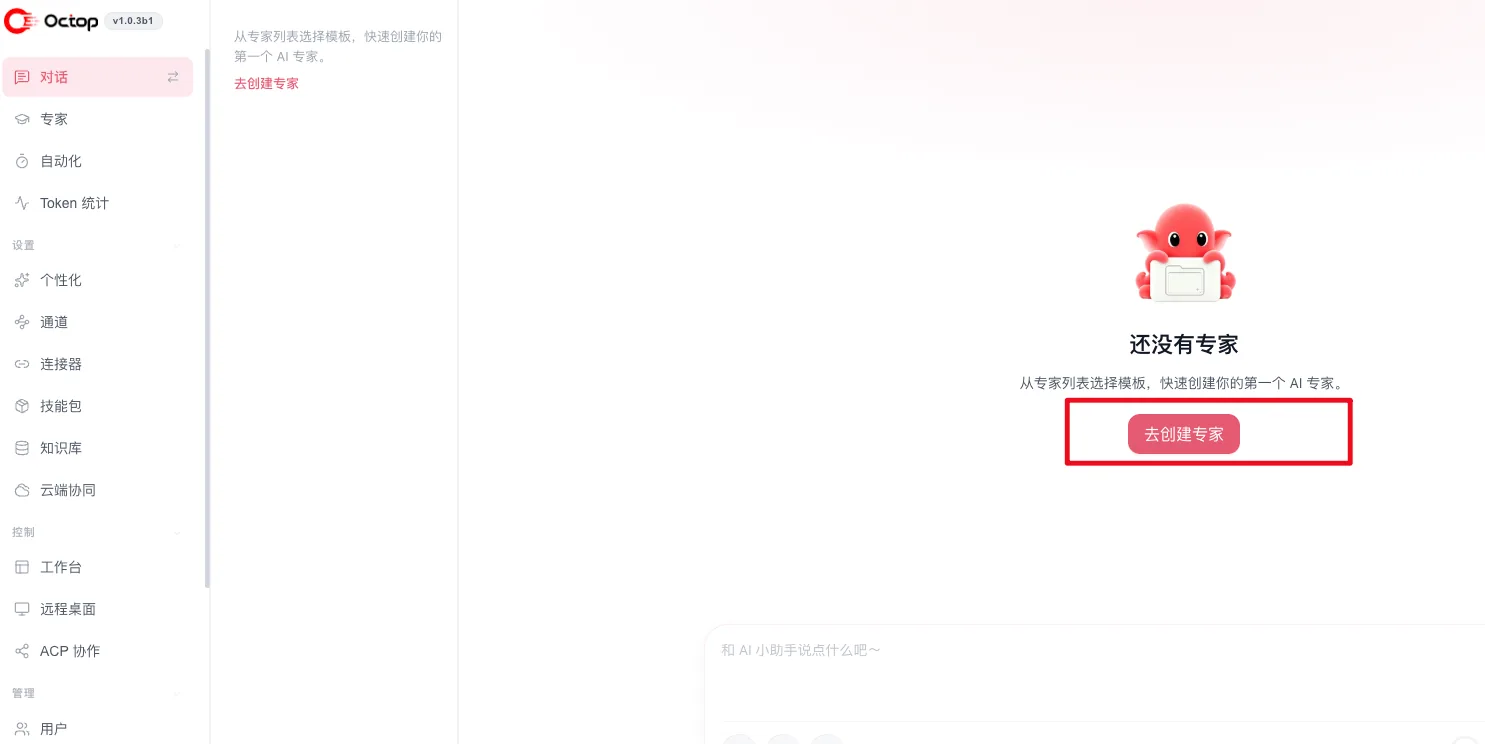
而配置专家之前太会提示你配置模型, 不然你没办法创建专家。
配置模型
Octop支持的厂商超级多,国内国外都有,大家选择自己喜欢的即可。
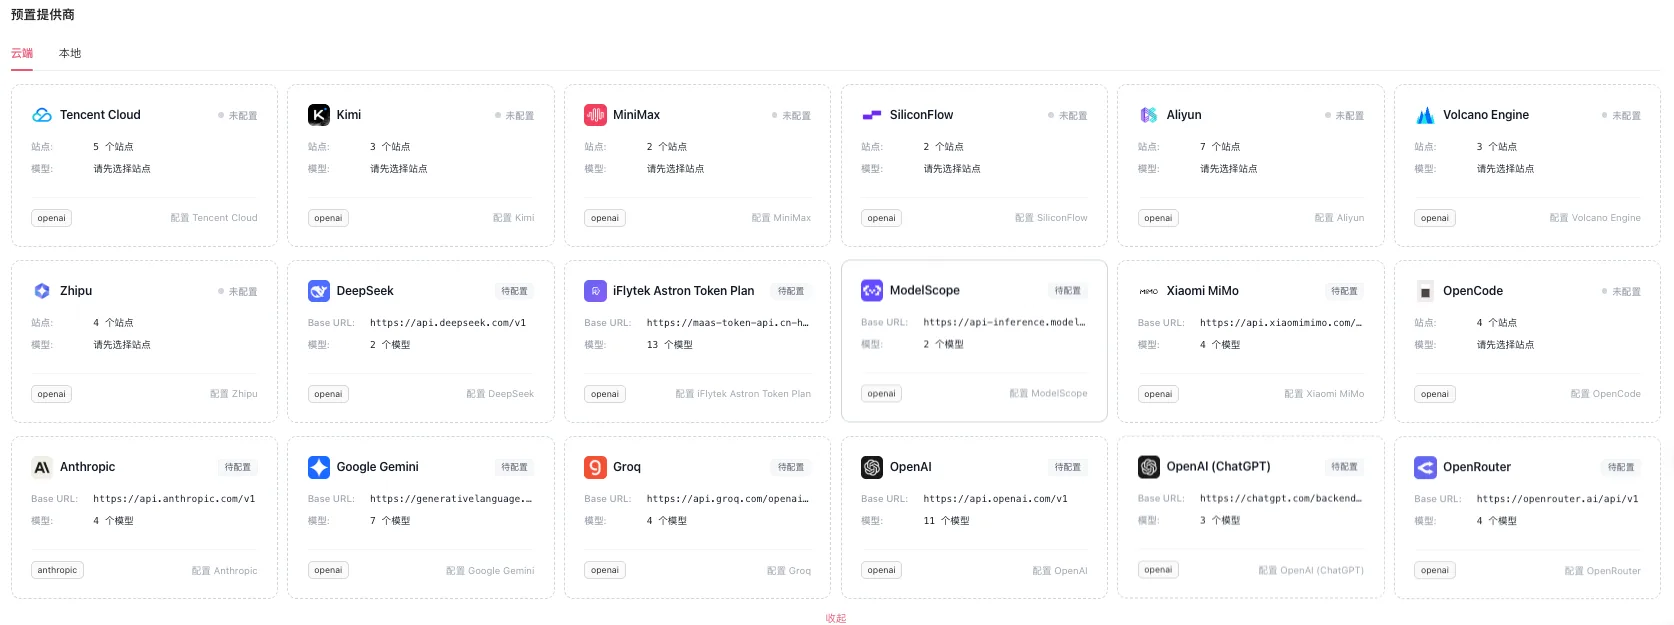
这里有一点很有意思,我使用的是opencode go订阅,它兼容性测试不通过,但是添加的模型测试是通过的,我暂时还没去找原因,后续看代码再看这一块吧。
*创建专家 创建专家可以自定义创建也可以从内置专家中选择,这个大家自己点一下就知道了。
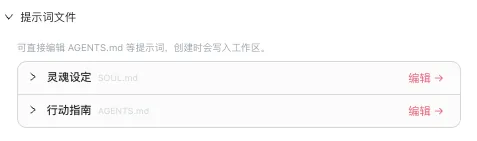
个人感觉内置专家模板和自定义创建的主要区别是一设置的提示文件不同。
自定义专家设置AGENTS.md
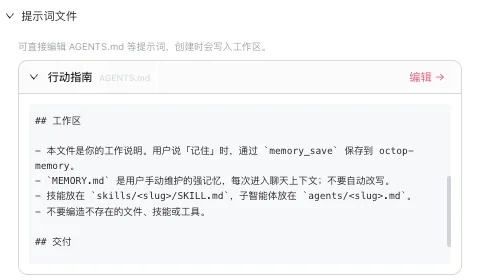
内置专家模板除了AGENTS.md,还可以设置SOUL.md
对话
对话框还是比较标准的,有思考链,有复制小按钮和重新生成,除此之外还有语音朗读和分叉,
简单的用起来之后,让我搞点基础理论冲淡一下使用的喜悦(哈哈哈)
它到底是什么
一句话:自托管的、多用户多 Agent 的平台,MIT 协议,这里有说了我认为最重要的两个点,一是多用户,多用户意味着可以用来团队使用,不用每个人单独配置环境和维护各种相关配置,比如skill, mcp, 知识库等, 二是MIT协议,这个协议似乎是当前开源项目中最开放的一个协议了,所以对于二次开发很友好。
官方 docs/architecture.md 里那张分层图,我按自己的理解重画了一遍:
值得注意的是,后面两行很重要:没有独立 worker,没有外部队列,除了你配的那家模型服务,不依赖任何外部组件。这一点在自托管场景里很值钱,特别是小团队的情况下——你不用为了跑一个助手去维护 Redis、Kafka、向量数据库三件套。
它和前几年那些「AI 应用平台」不太一样,侧重点不同:
| Octop | 工作流编排类(Dify/n8n 这类) | 单机 CLI 编码助手 | |
|---|---|---|---|
| 主要形态 | 多用户 Web 平台 | 可视化拖节点 | 终端里一个会话 |
| 隔离单位 | Agent(每个有工作区和记忆) | 应用 / 流程 | 一个会话 |
| 能不能碰你的机器 | 能,有终端、文件、浏览器工具 | 一般不碰本机 | 能,但只服务你一个人 |
| 多用户 | 内置账号、角色、权限、配额 | 视产品而定 | 基本没有 |
| 接 IM | 内置 10 个通道 | 通常靠插件 | 没有 |
代码规模可以感受一下:src/octop 下 api 有 62 个 router,infra 分了 25 个领域模块,tests 里有 548 个 Python 测试文件。几个大文件:infra/agents/manager.py 4187 行、infra/bridge/manager.py 2552 行、infra/db/migrate.py 2110 行。这套东西不算小,但结构是能读的——我后面会开一个「读 Octop 源码」的系列专门拆它。
技能,识库和连接器(MCP)
这些默认都是没有启用的,不过内置了一堆的技能和连接器,根据自己需要选择即可,需要使用某一行业或者领域的专业知识就去启用技能,需要链接外部系统就去找连接器启用
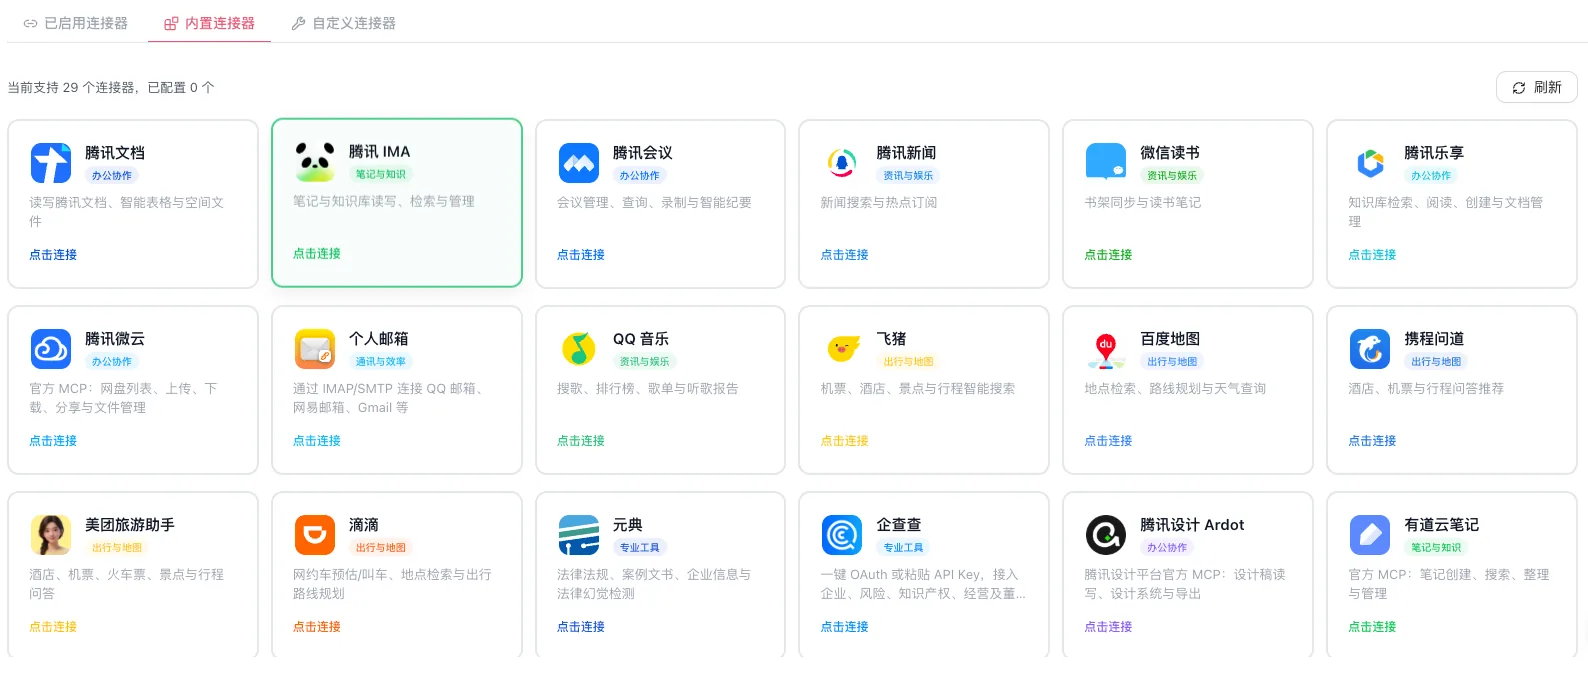
技能(skill)是给 Agent 的「操作手册」,本质是一份 SKILL.md,写清楚什么时候用、怎么用、有哪些命令。Octop 内置了一批,也可以自己写,或者从插件里同步进来。这个和workbuddy等各大平台的差不多,是可以移植的。这个没太多可以说的,安装即可。
知识库是检索侧的东西,上传文档,可设共享(别人只读)。
个人建议先别急着灌知识库。多数人第一周真正缺的不是知识,是「这个 Agent 知道该怎么干我这一行的活」——那是技能要解决的问题,一份写得好的 SKILL.md 比十个 PDF 有用。
多用户:账号、角色、配额
一个人用的话这节可以跳过;但只要打算给同事开号,有几点必须先想清楚。
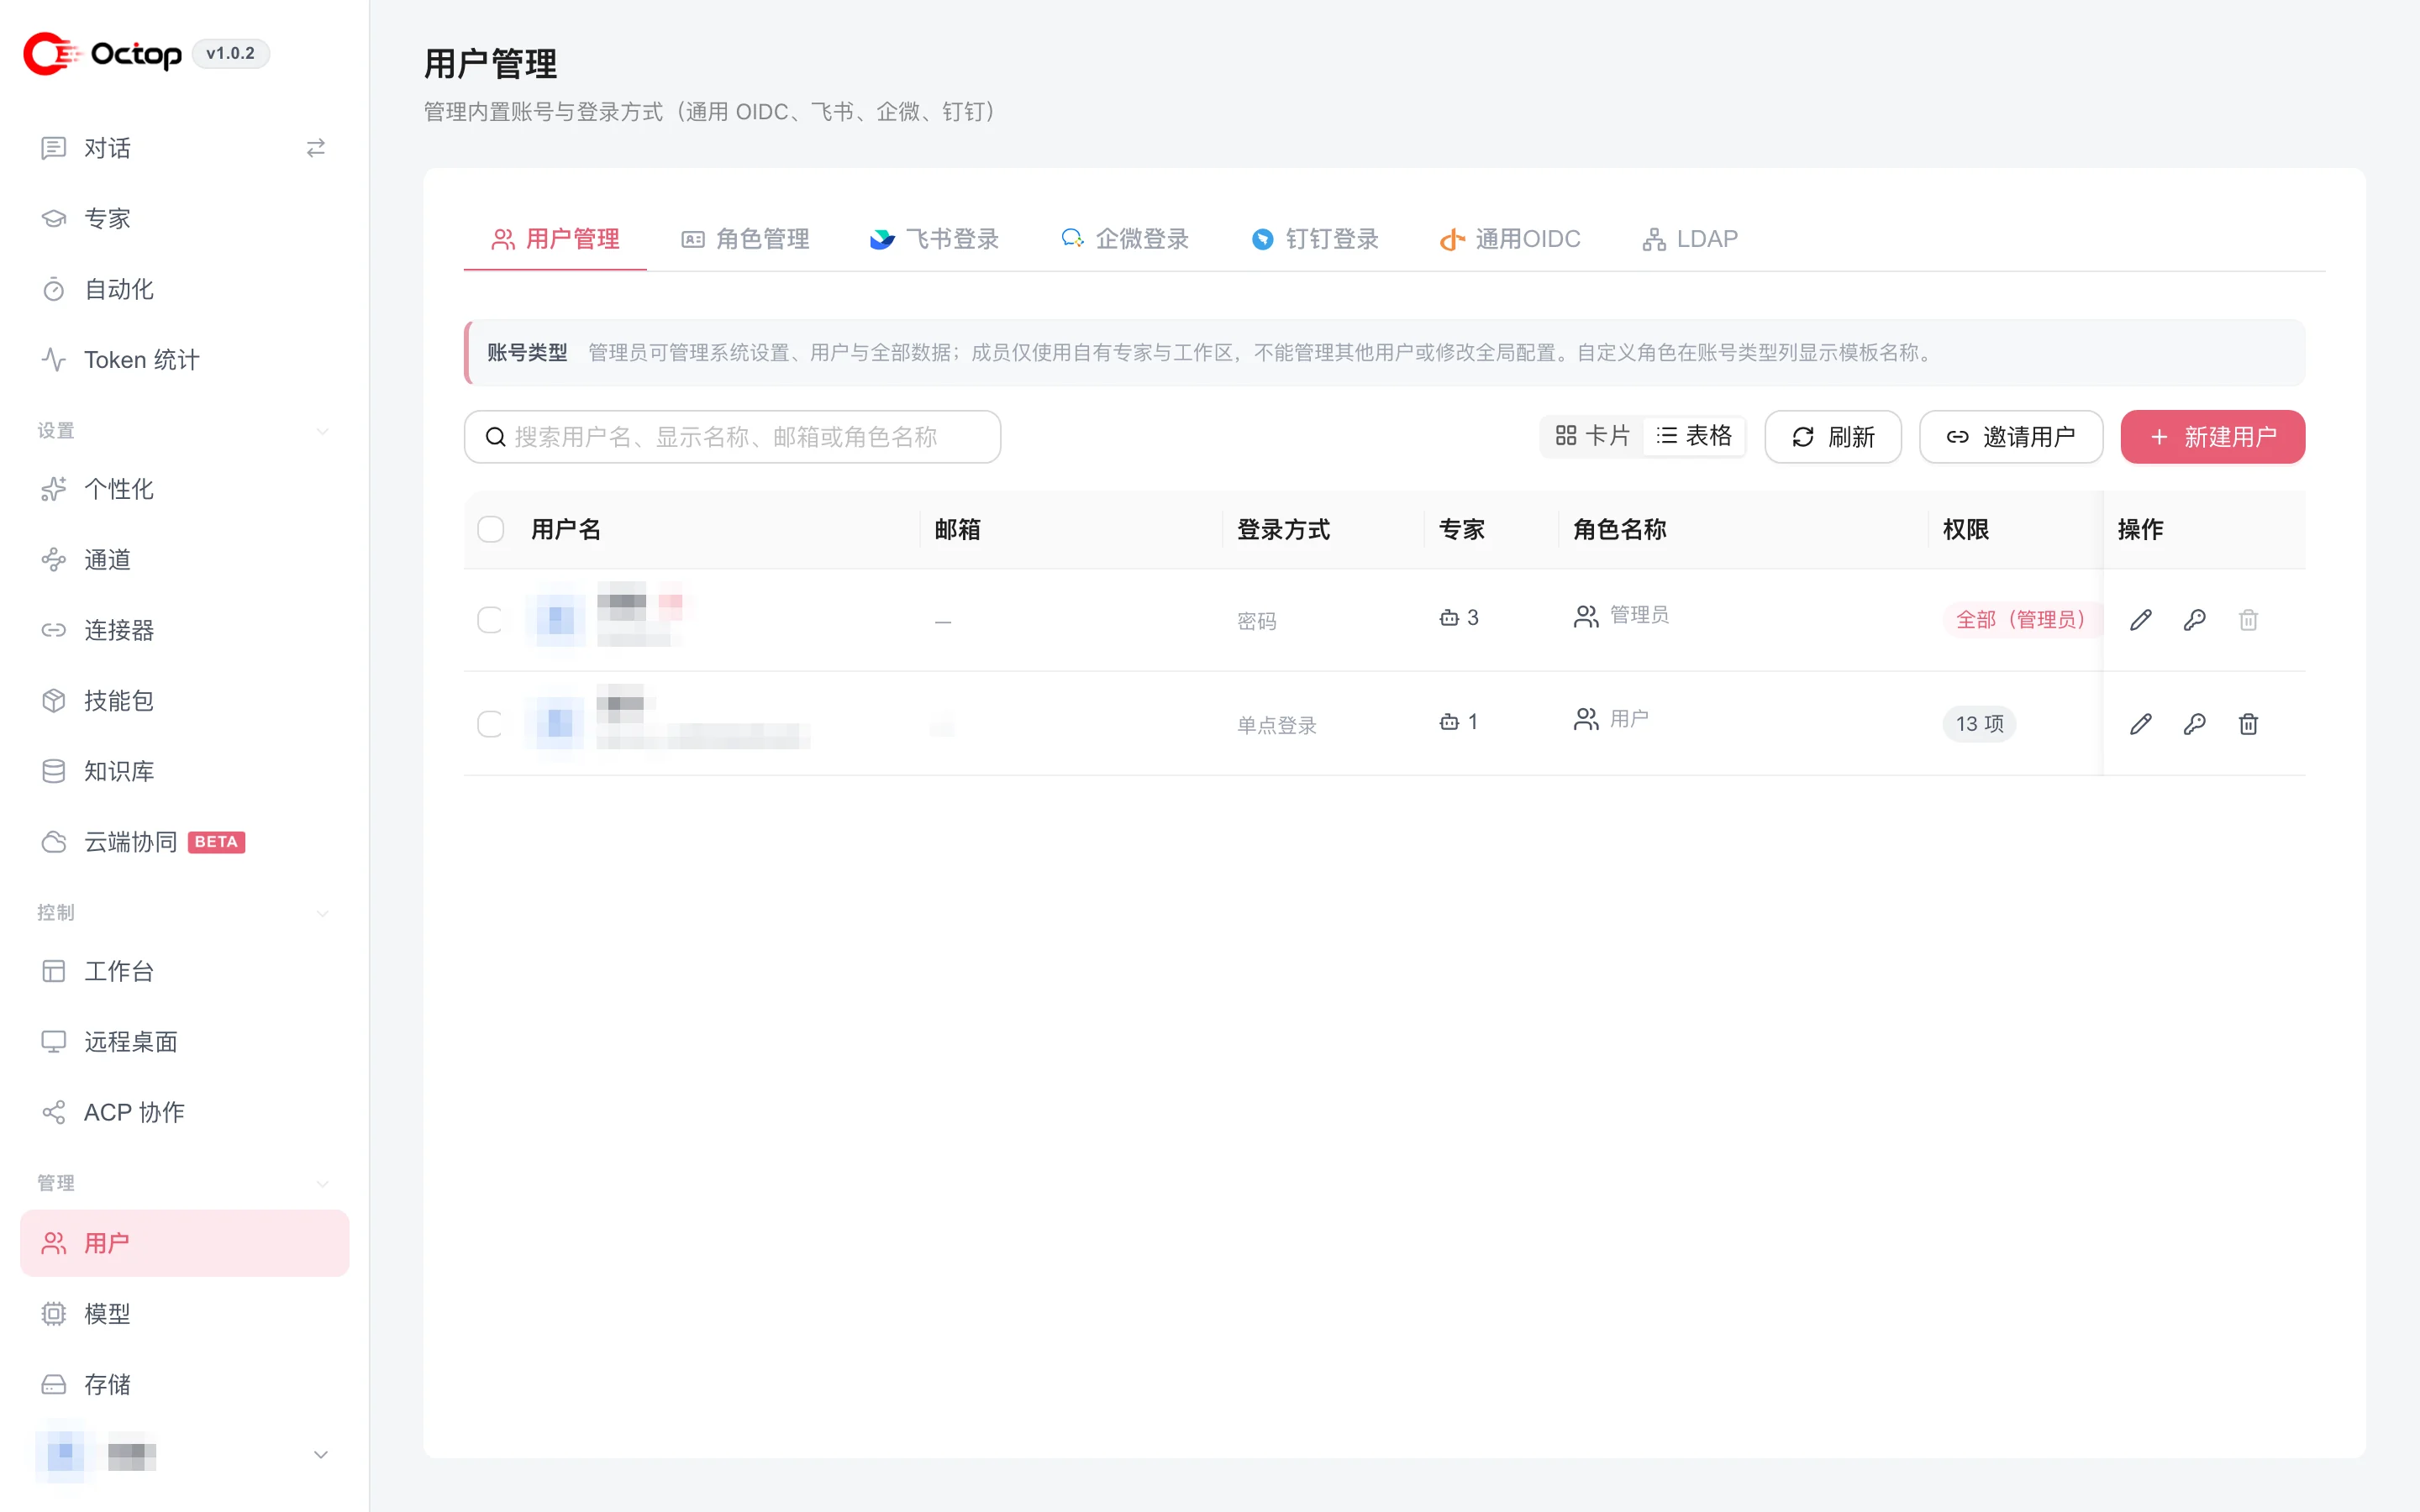
登录方式有五种:
| 方式 | 适合 | 备注 |
|---|---|---|
| 本地账号密码 | 自己和小团队 | Argon2id 哈希,有失败次数锁定 |
| 邀请码注册 | 让同事自助注册 | 可绑角色模板和有效期 |
| 飞书 SSO | 公司已经有飞书 | 首次登录自动建号 |
| 企业微信 / 钉钉 | 同上 | 配置入口在「用户管理」页 |
| 通用 OIDC / LDAP | 已有统一身份 | 适合接入既有账号体系 |
命令行建号更快:
octop user create <用户名> --password '<密码>' --role user
octop user list
octop user passwd <用户名>
octop user role <用户名> admin
权限上,管理员是「全部权限」,普通用户默认给 13 项(能用自己的专家和工作区,不能改全局配置、不能管别人)。这个默认值我觉得是合理的,但它对资源没用约束——token_quota 和 max_agents 默认是「不限」。多人场景务必逐个设,理由在安全那节展开。
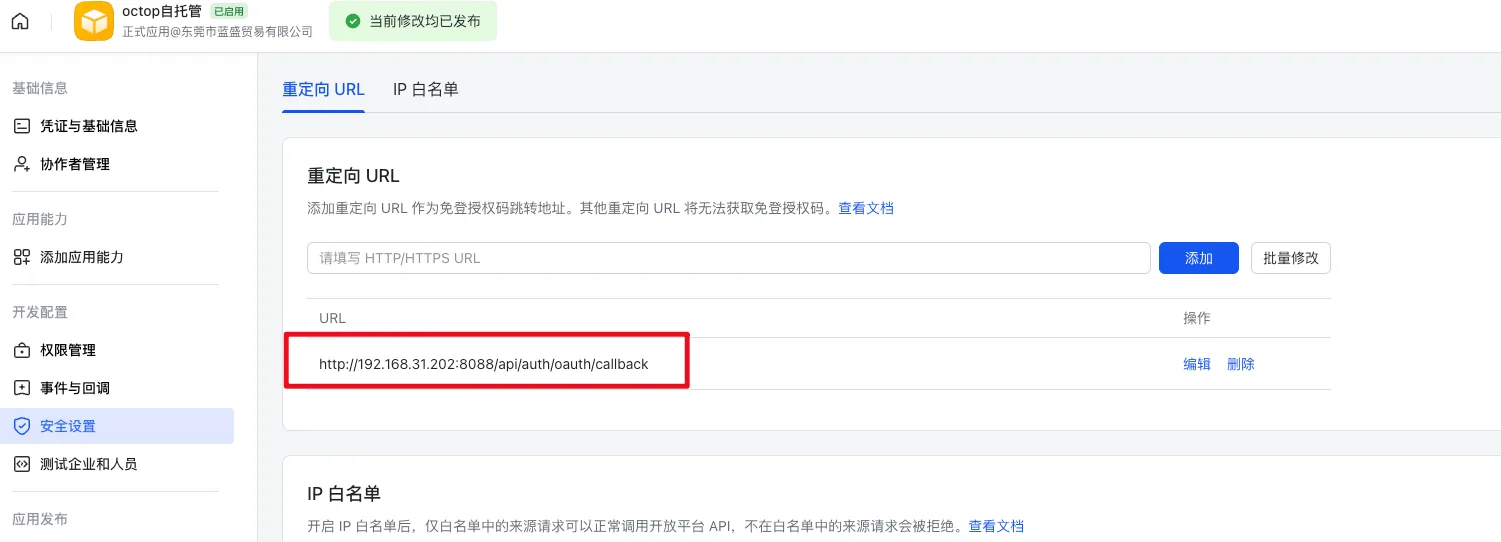
我这里测试了两种登录方式,飞书和企业微信,它们两个配置起来都不复杂就是去对应的开放平台创建企业应用并配置回调地址。比较大的区别在于两者对于回调地址的要求不同,前者可以配置一个IP地址,不需要域名,更不需要公网可达,后者需要一个域名。
飞书如下,可以直接配置内网地址的回调:
企业微信如下:
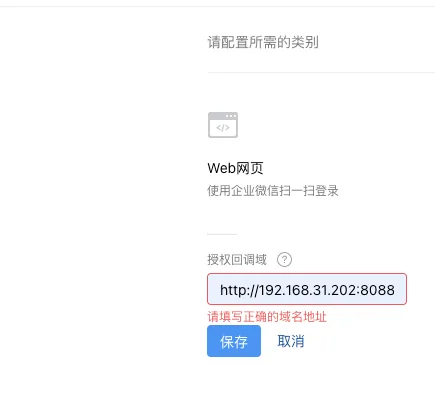
所以飞书对于AGENT的各项支持都非常友好,包括飞书登录。如果没有公网服务器和IP,只想内网使用,使用飞书作为登录就挺好,用户可以不用记忆一套额外的账号密码,当然了,如果你有LDAP的账号体系,也可以接入。
接 IM:让它在飞书里回你消息
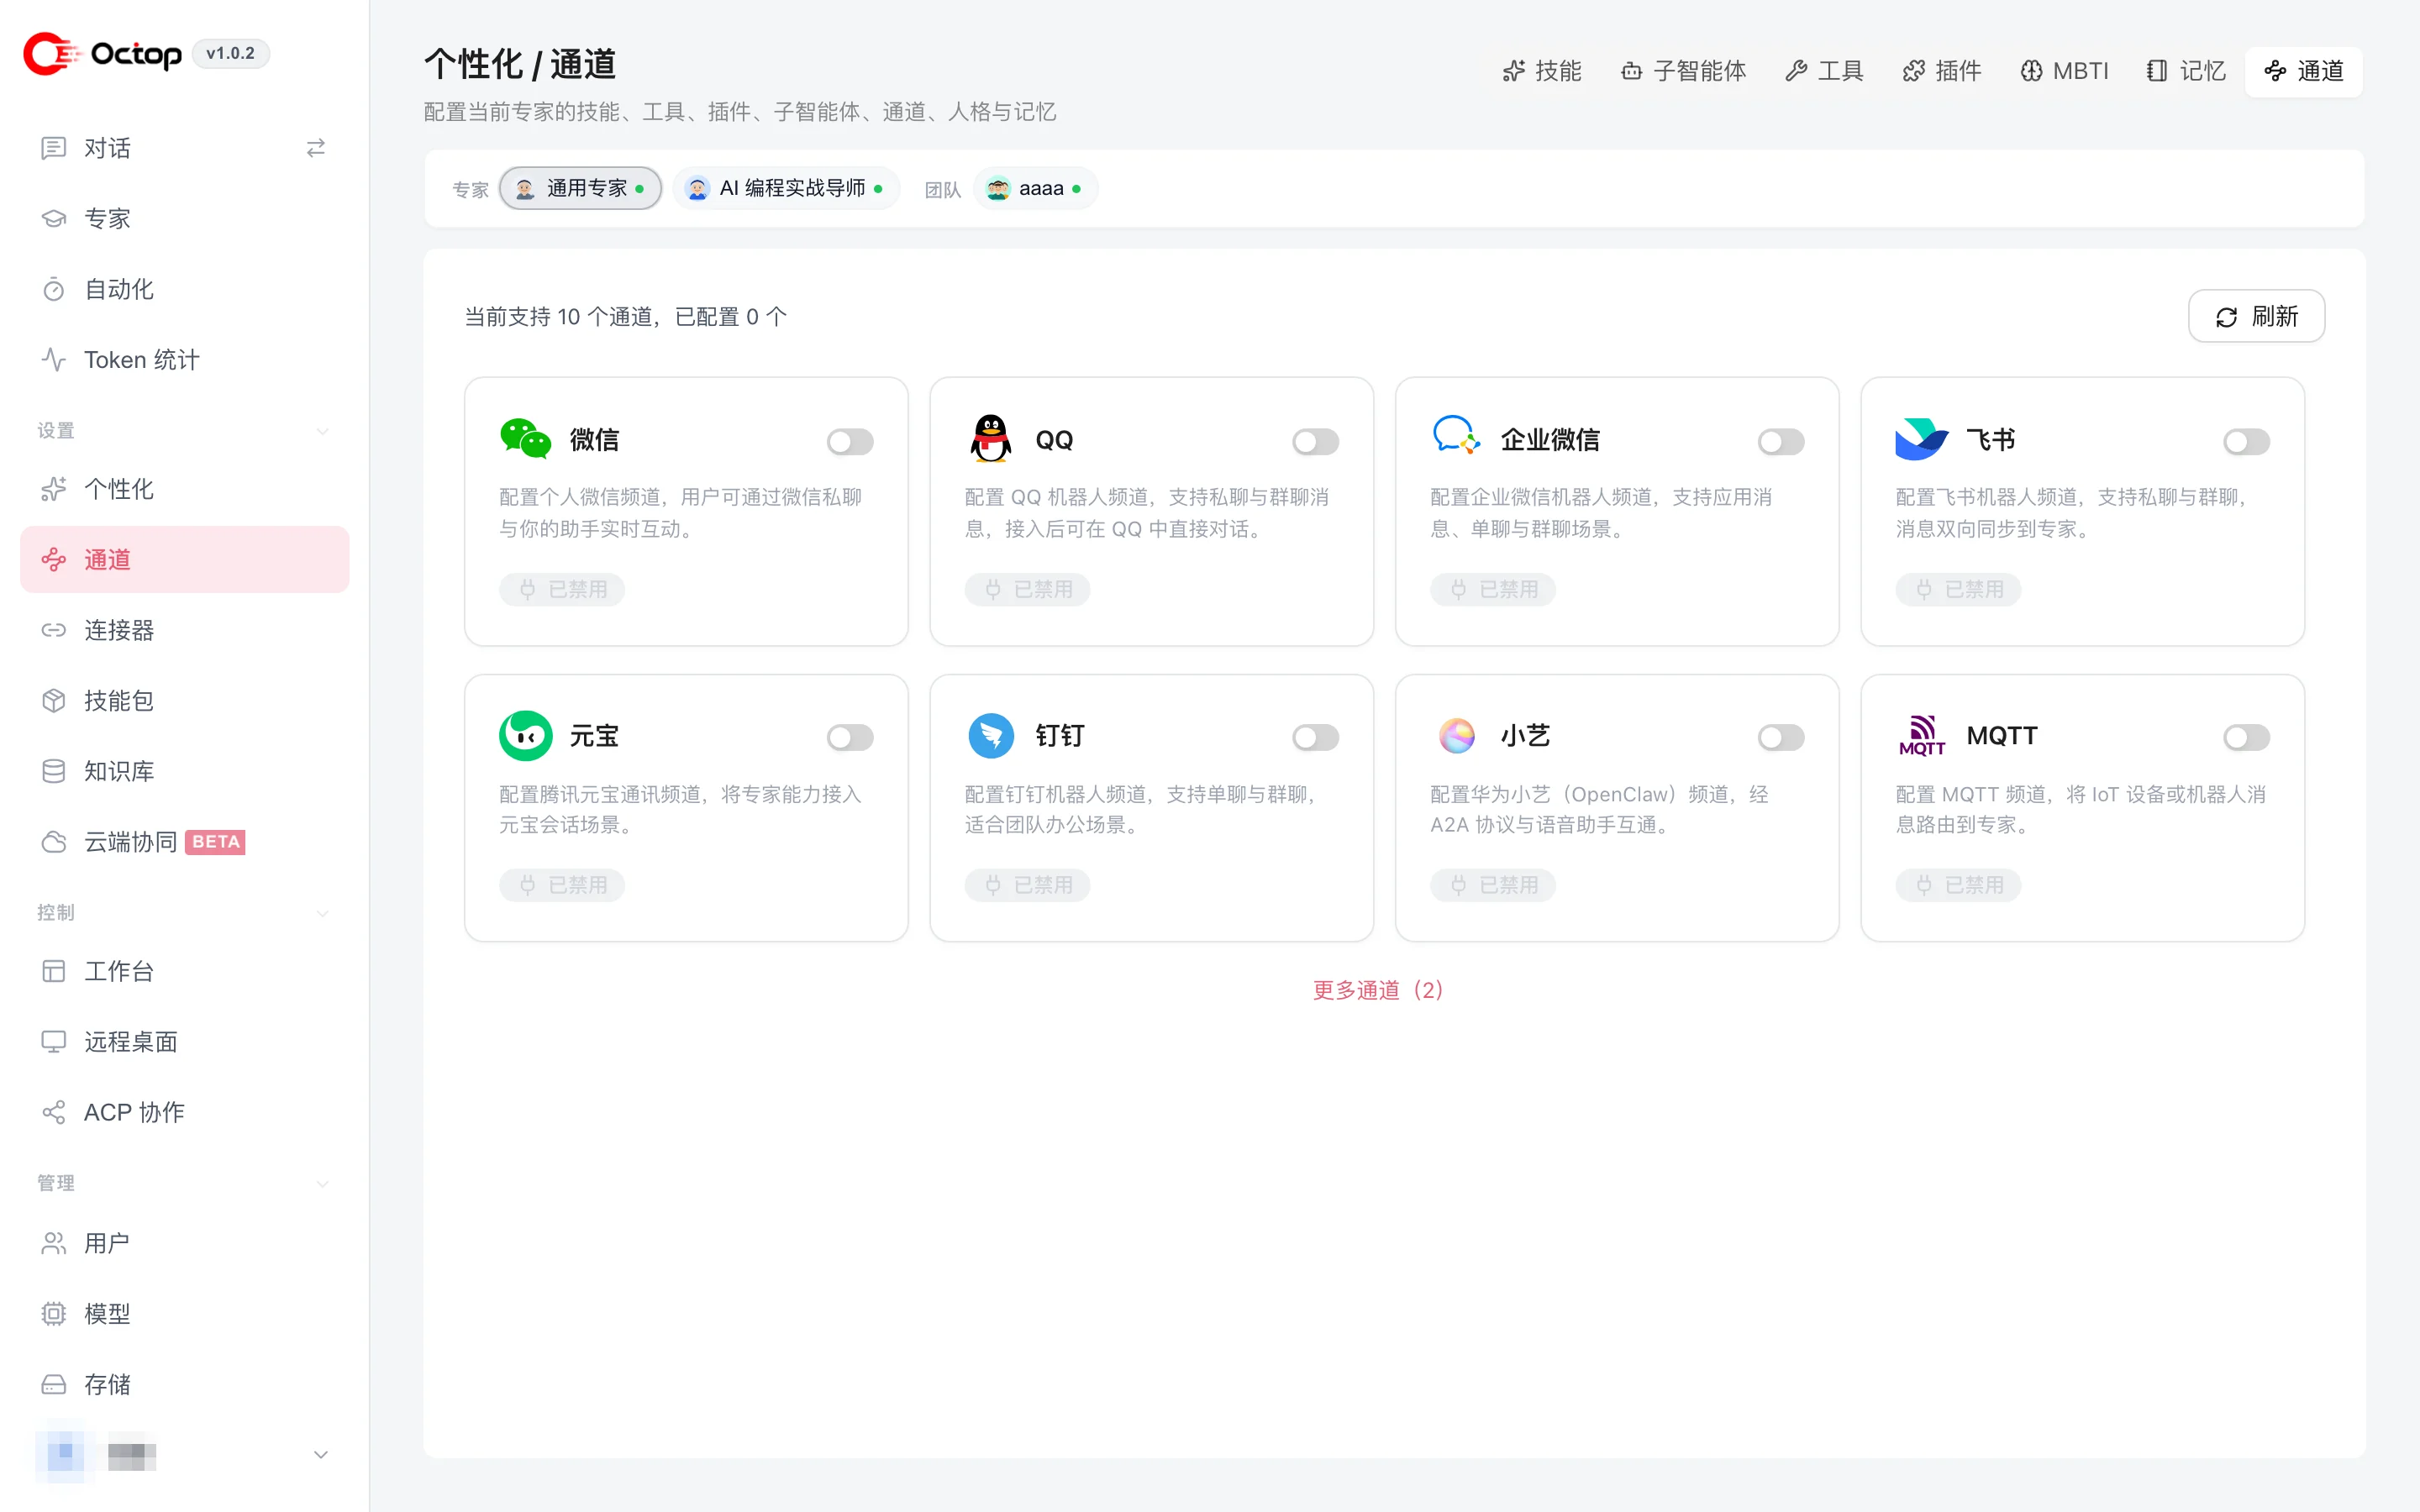
Octop 内置 10 个通道:
大多数链接通道连接之后就可以扫码使用了,参考下面的截图。
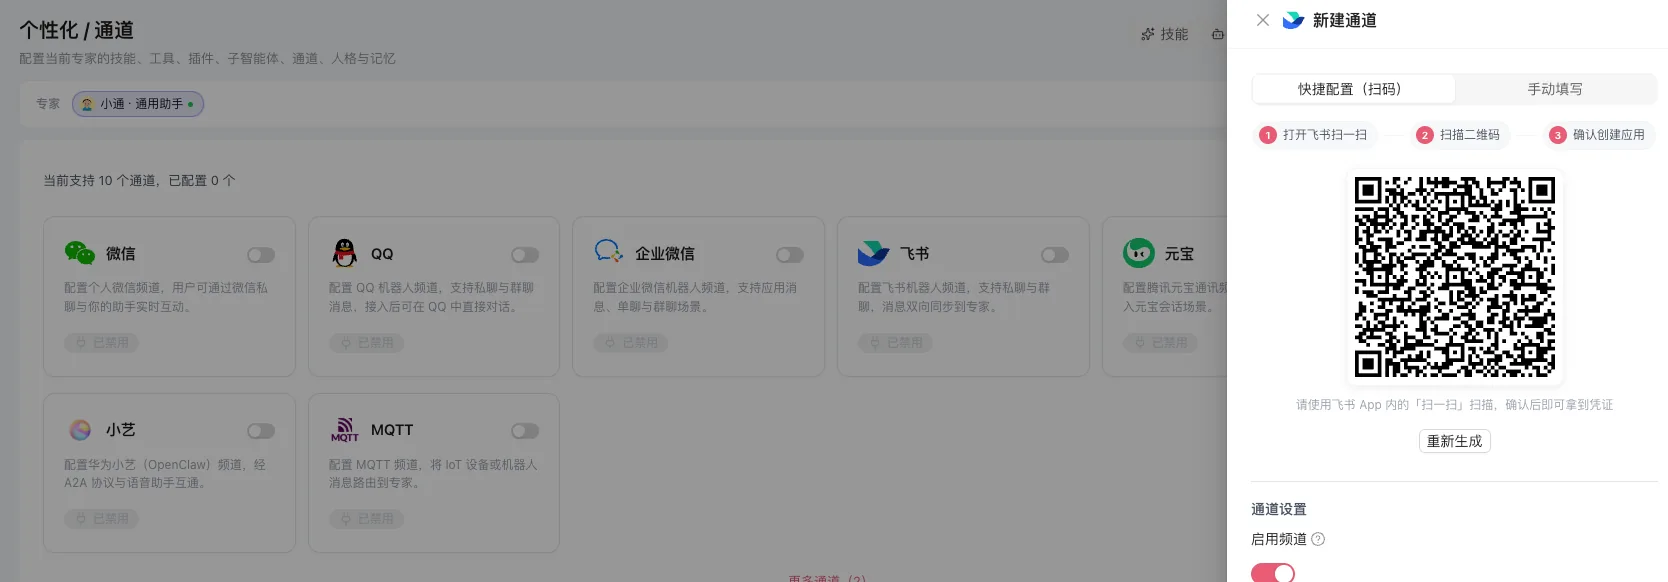
配置在「个性化 → 通道」,选的是当前这个专家用哪个通道。以飞书为例,流程是标准的机器人接入:填 App ID / App Secret,然后二选一——
- 长连接模式:不需要公网 IP,本地服务主动连出去,适合自己电脑上跑
- 事件回调模式:飞书把消息推到你的 HTTPS 地址,需要公网可达 + 签名校验
自己玩就用长连接,省掉内网穿透和证书。
通道支持单独启用/停用,也支持「仅私聊」这种粒度。真实体验是:配好之后你在飞书里发一句,Agent 在服务器上干活,结果回到飞书——平台退到后台,你只在 IM 里说话。这个形态比开网页舒服得多。
定时任务
「自动化」里可以按 cron 挂任务,让 Agent 定点干活:
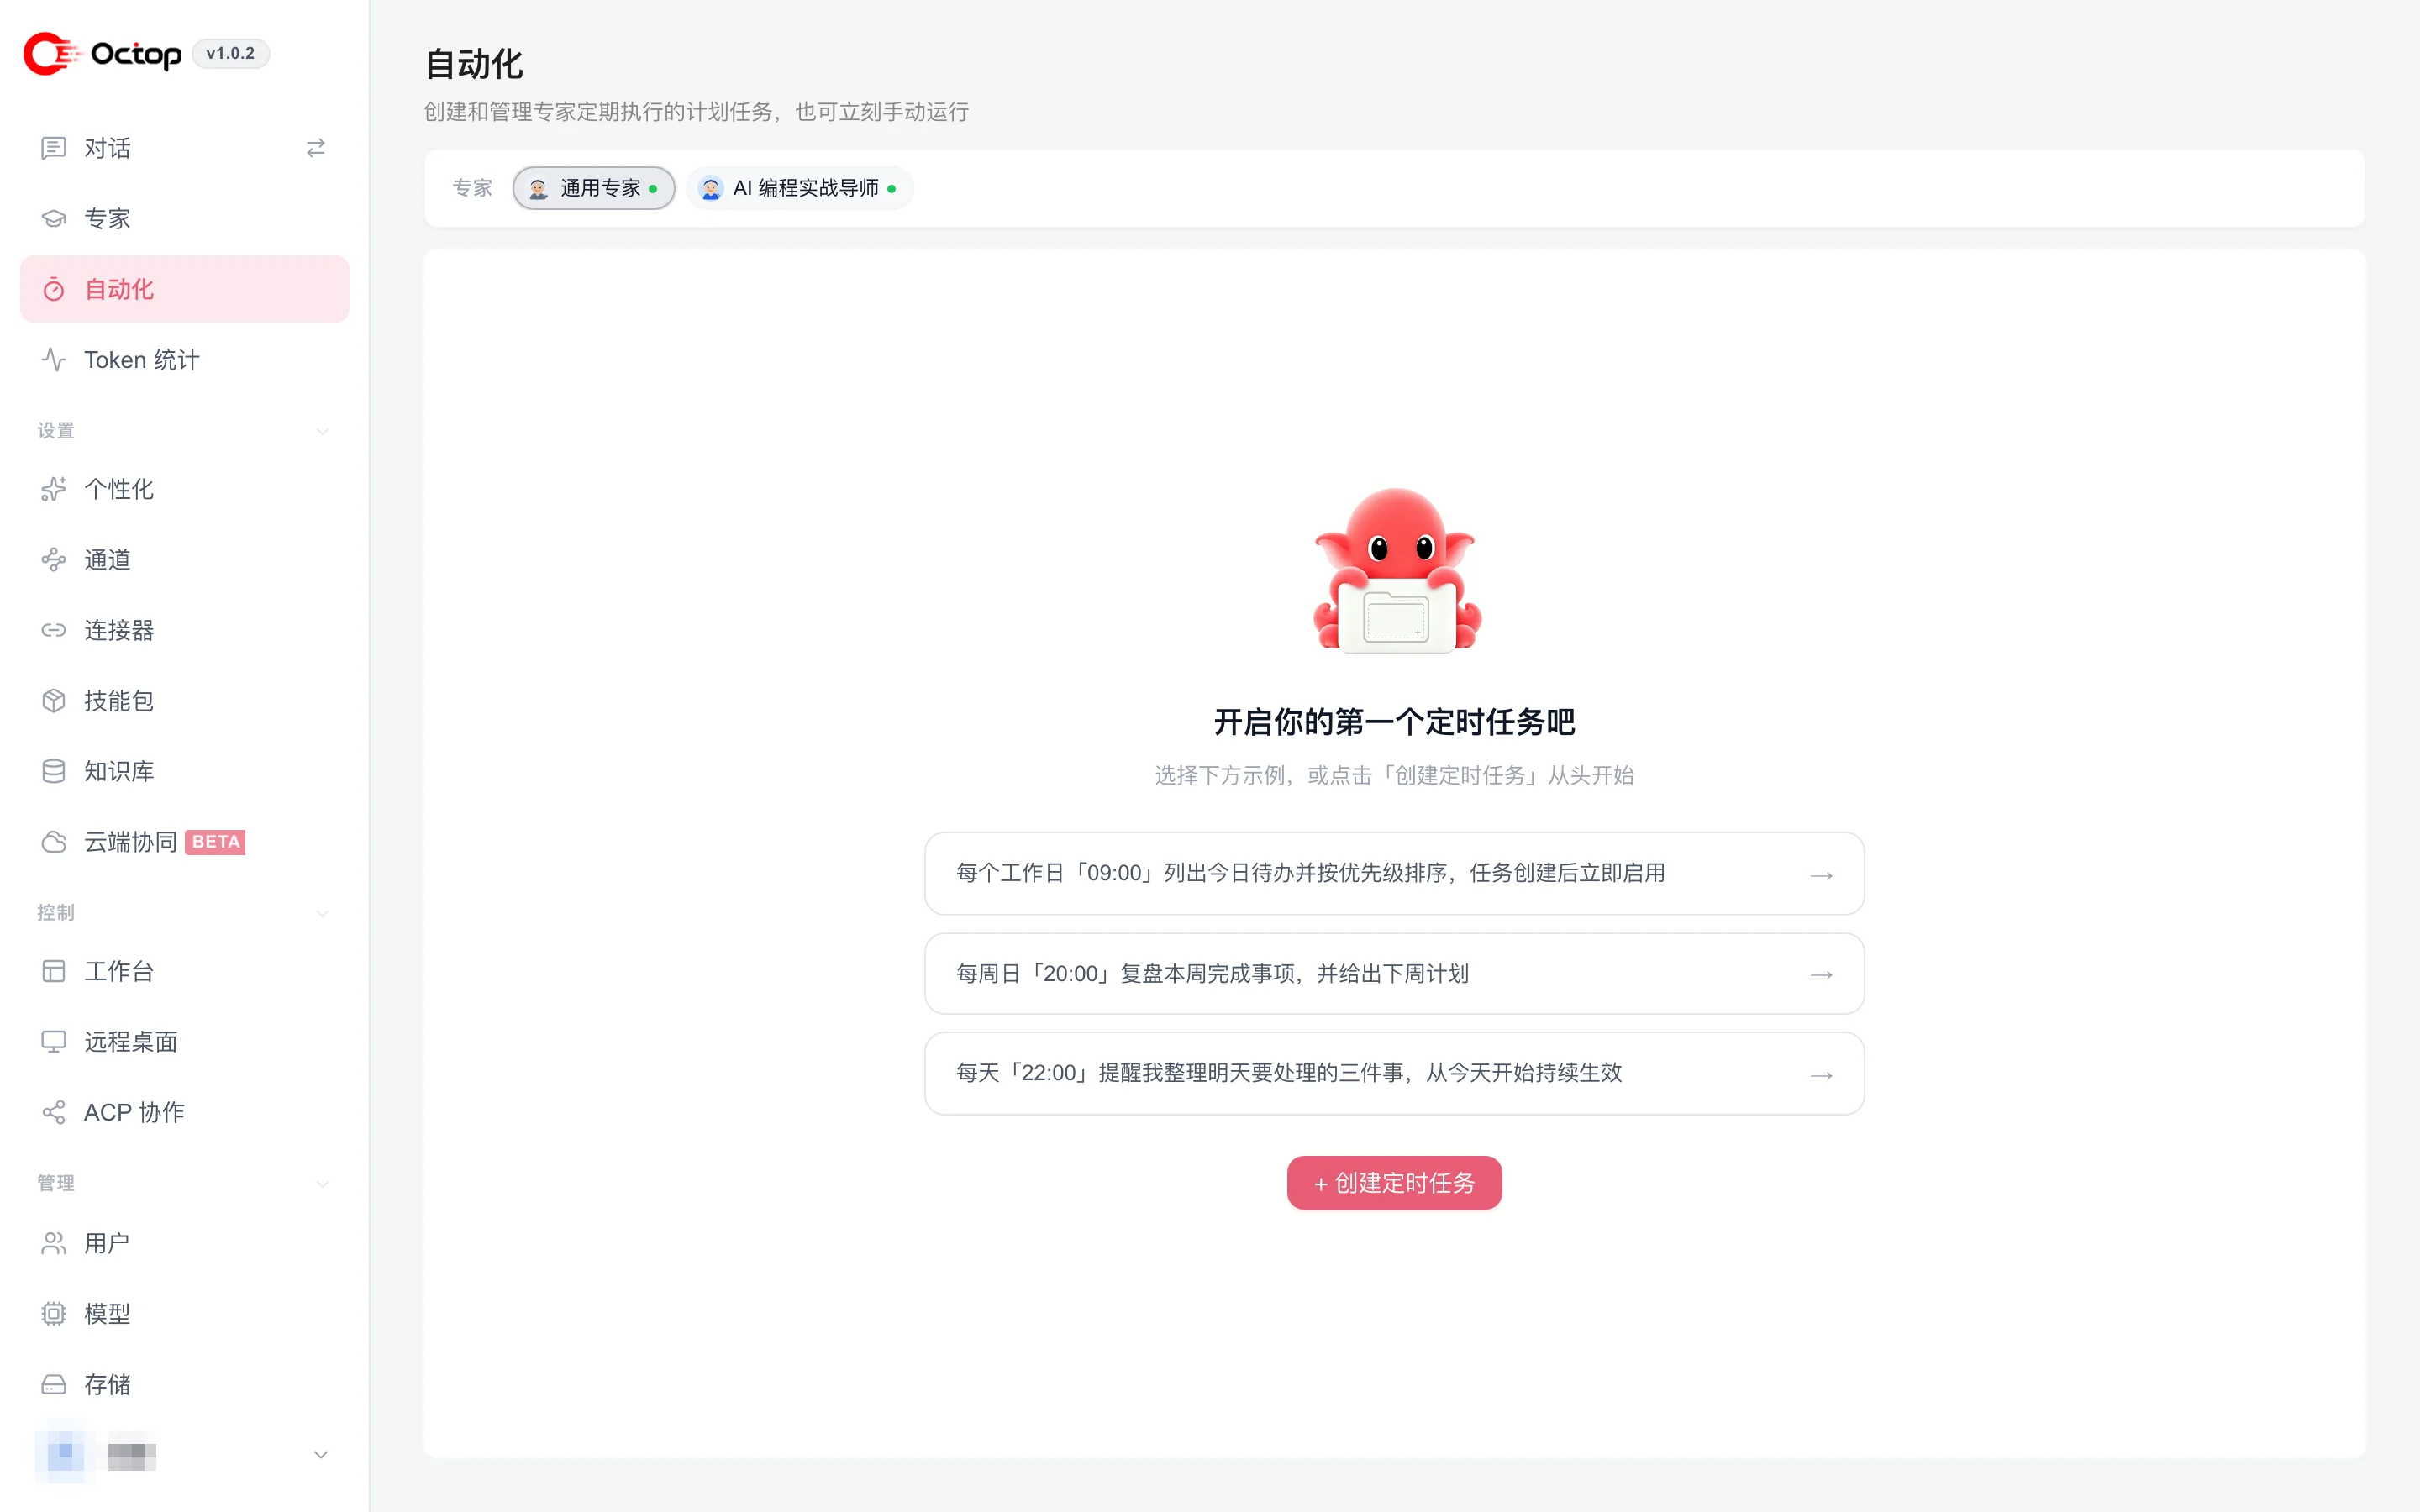
octop cron --help # 命令行管理
三个我用得上的例子:每个工作日 9:00 汇总待办并按优先级排序、每周五复盘本周、每天 22:00 提醒明天的三件事。
注意定时任务触发的是一个 Agent 的一次完整回合,所以那个 Agent 得有模型、有权限、工作区里的脚本也得在。任务跑失败先看这三样,比看日志快。
花了多少钱
管理里有个 Token 统计,按天/按专家/按模型三个维度看:
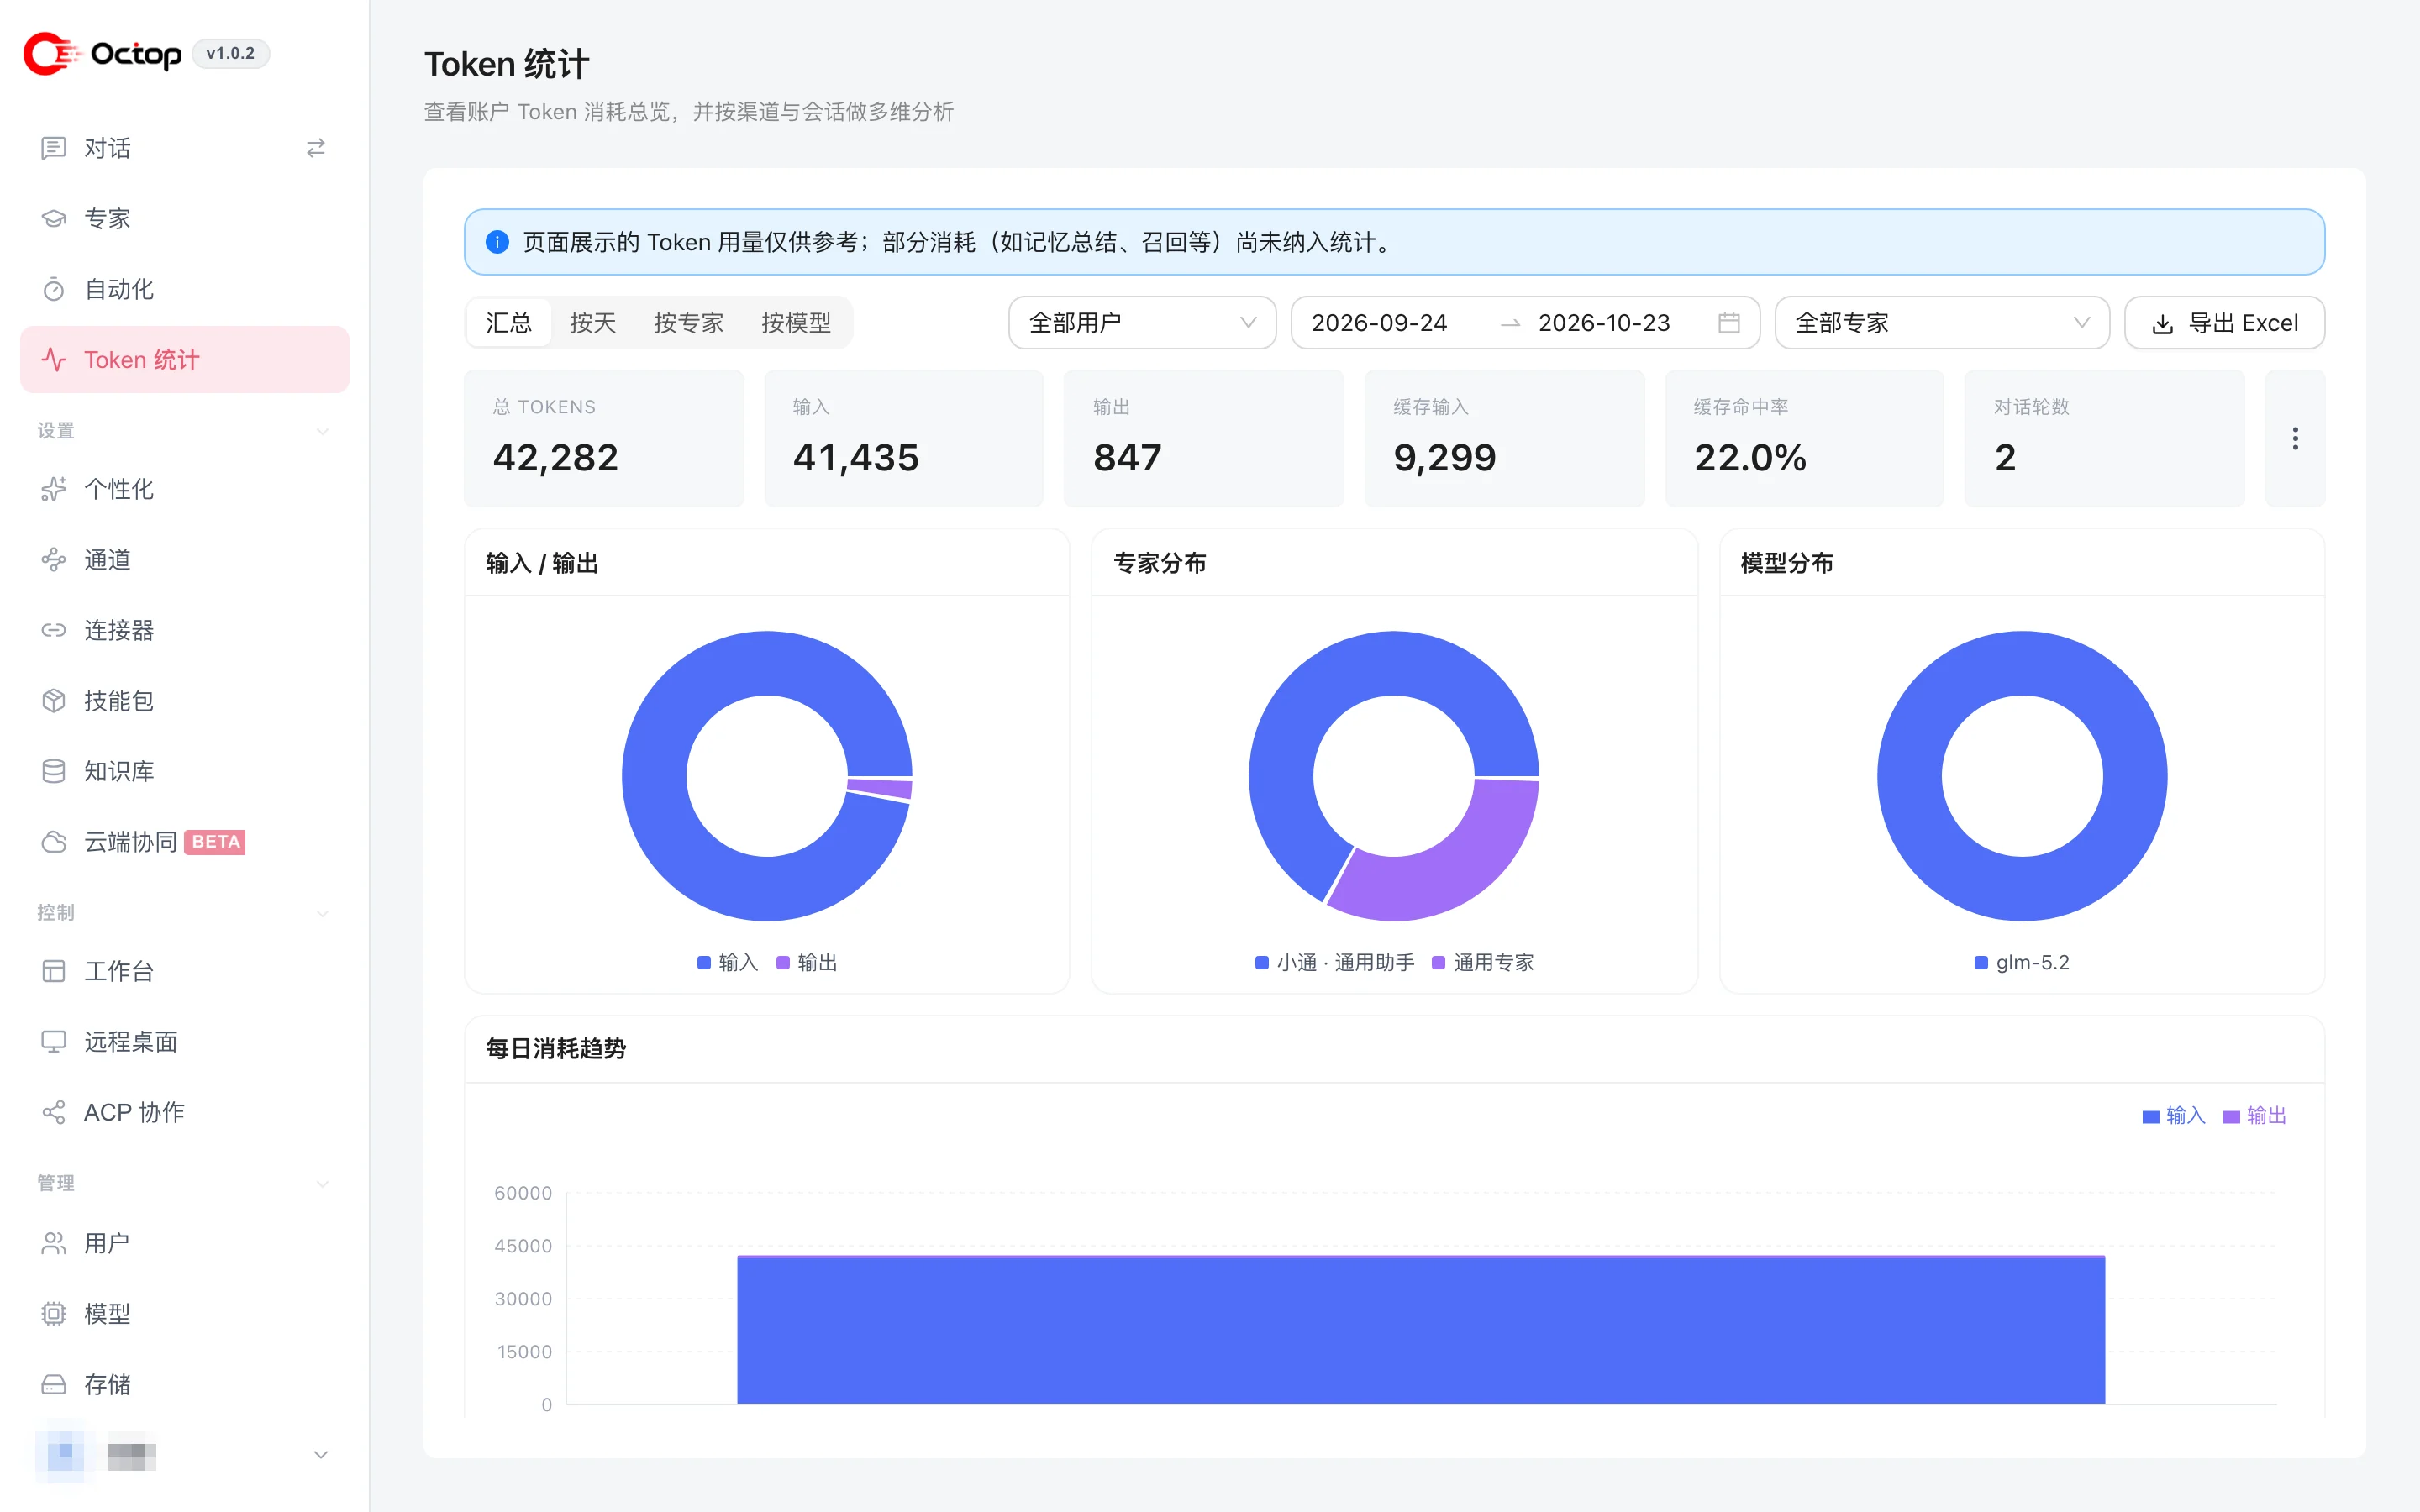
这张图里有个数字值得单独说:缓存命中率 22.0%。输入 41,435 tokens 里 9,299 是缓存命中的,这部分价格通常只有正常输入的几分之一。自托管最容易忽略成本,因为账单不在一处——每家供应商各算各的。这个面板至少能让你知道钱花在哪个专家、哪个模型上。
页面自己标了一行小字:「部分消耗(如记忆总结、召回等)尚未纳入统计」。所以它是下限,不是准确值,做预算时留点余量。
写一个插件(内置不够用的时候)
到这里你已经有一个能用的平台了。但真用起来一定会遇到「内置工具差一点」的情况:想接自己公司的内部 API、想加一个特定的文本处理、想让每次对话开始前先做点什么事。这时候可以选择写一插件。
先理解它是什么:一份目录契约
插件不是什么复杂的二进制扩展,就是一个目录,里面两样东西:
my-first-plugin/
├── plugin.yaml      # 元数据:id、版本、kind、入口文件
└── main.py          # 入口:必须定义 setup(ctx)
plugin.yaml 的字段,管理页的「如何开发并导入插件」里写得很清楚:
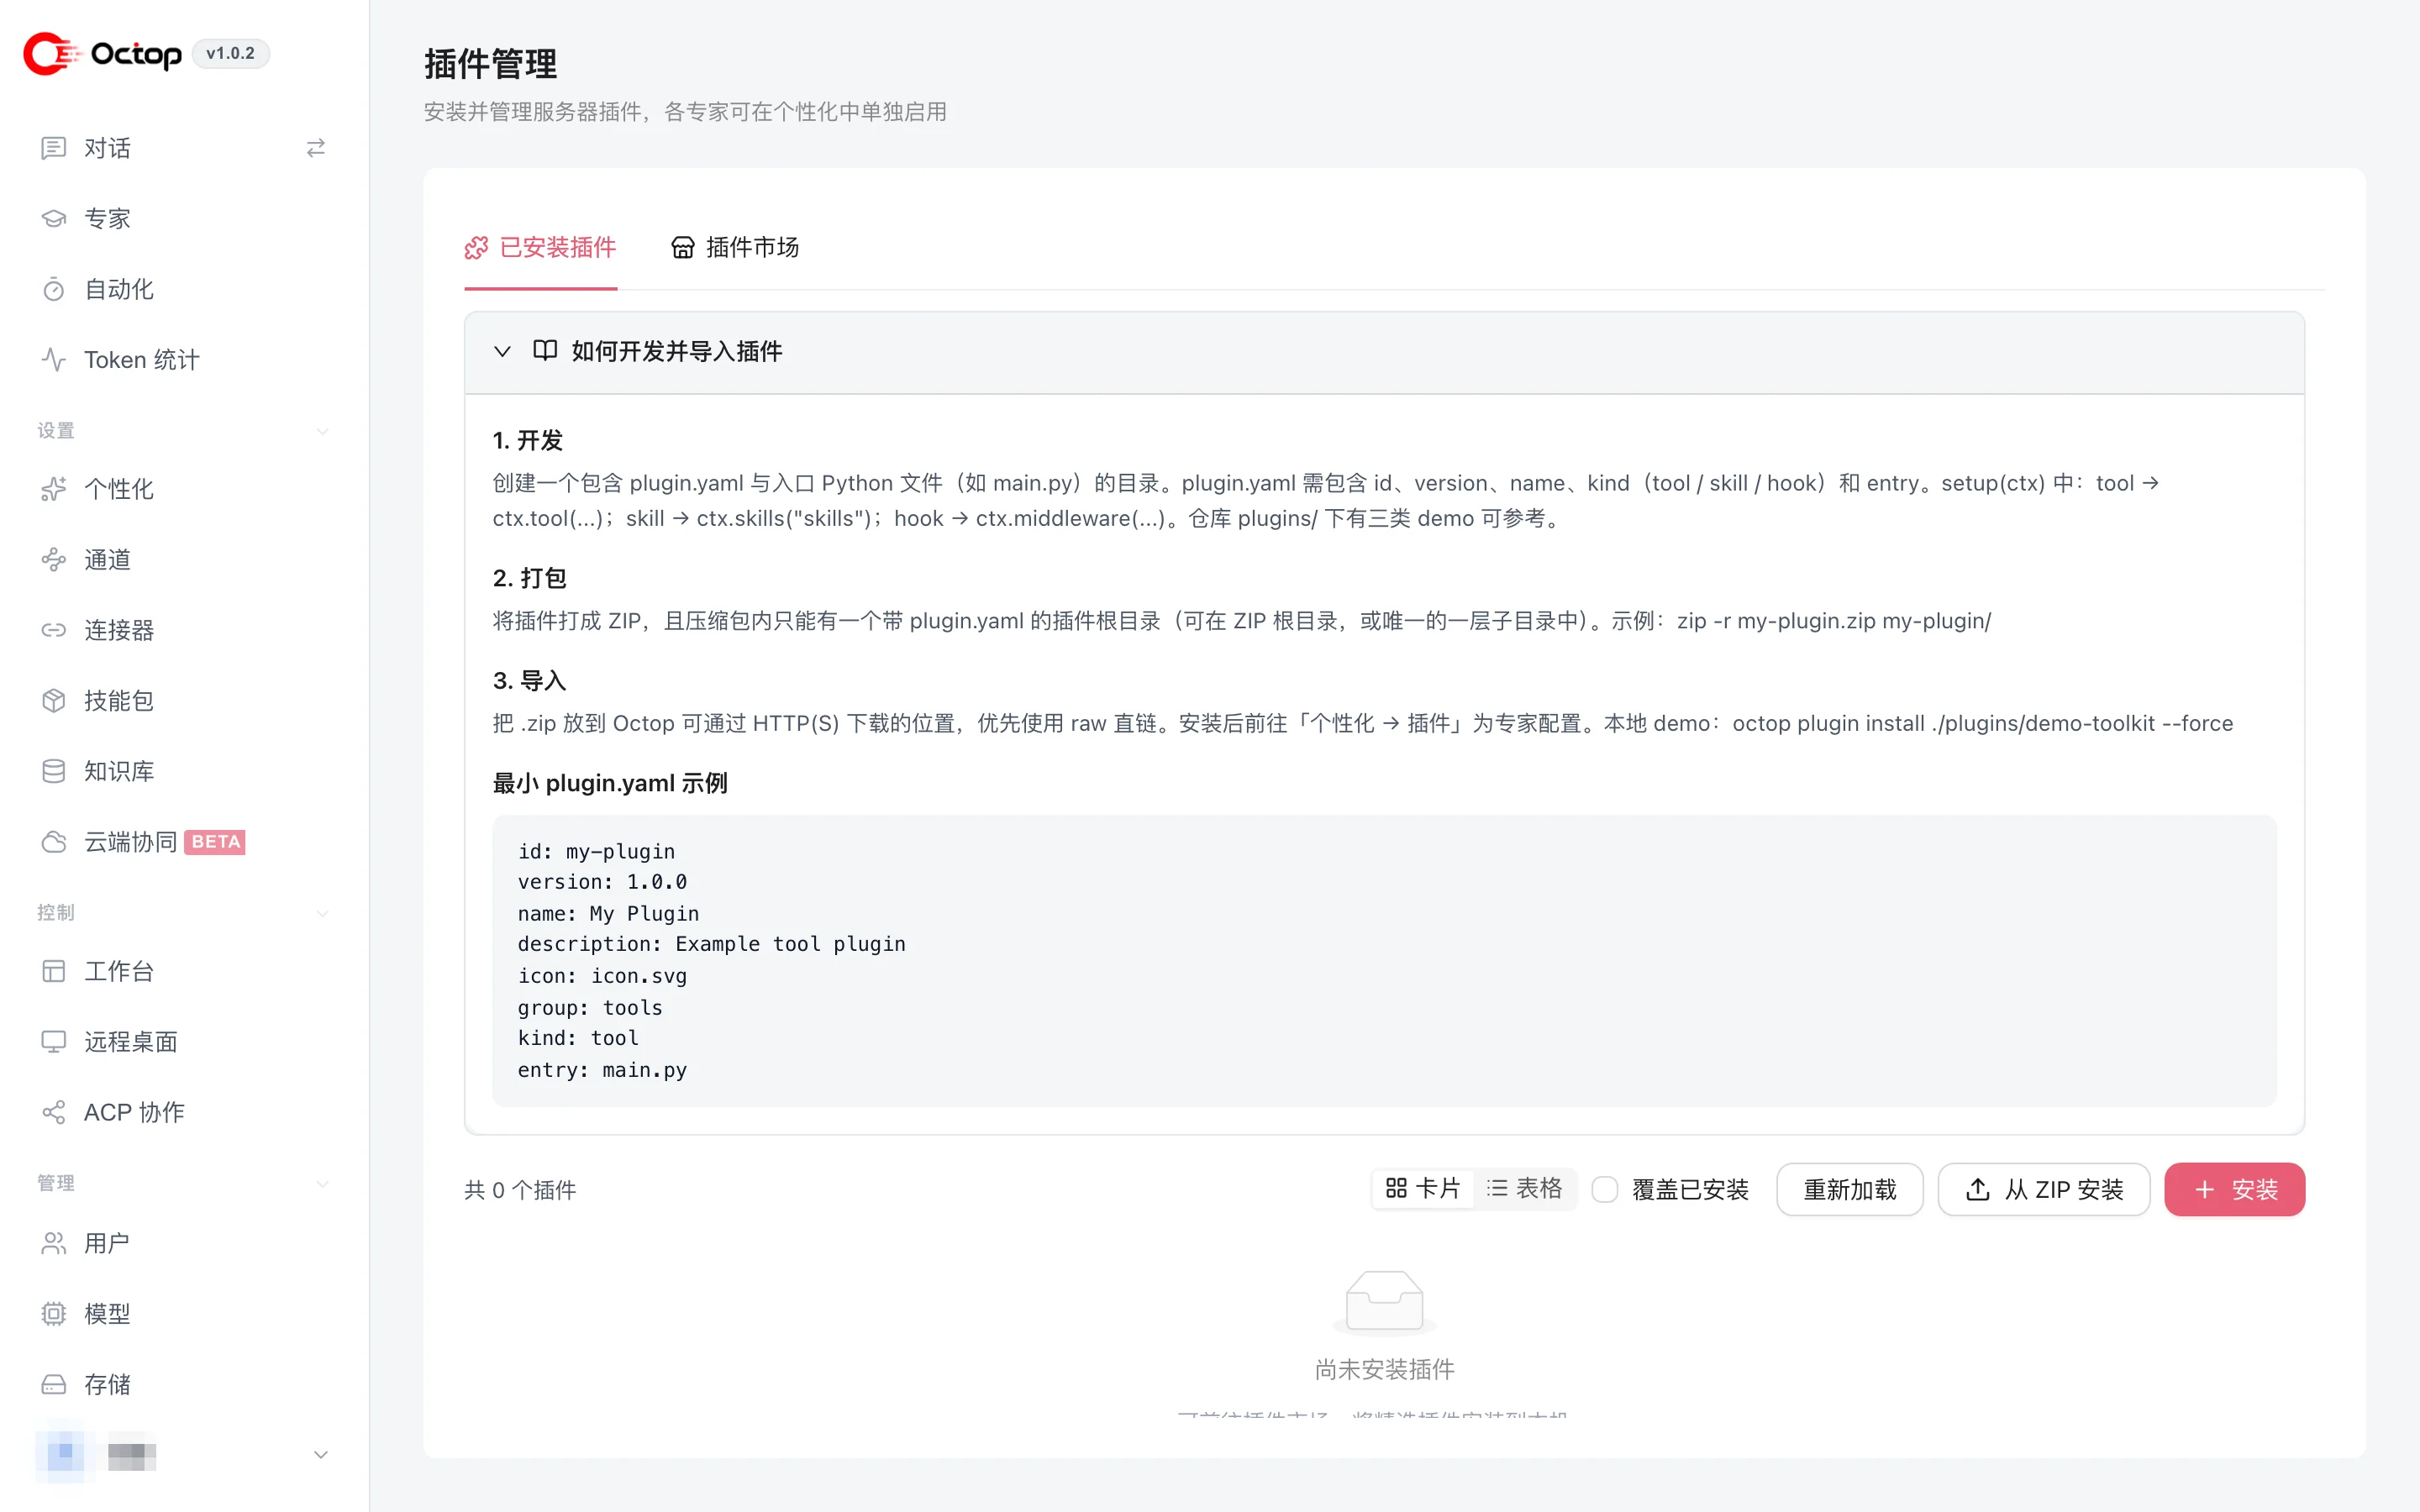
| 字段 | 作用 |
|---|---|
id | 唯一标识,装多个插件不能重名 |
version | 版本号,重装时用来判断 |
name / description | 显示在管理页上的名字和说明 |
icon | 一个 emoji 或图片文件名 |
group | 分组,比如 tools |
kind | 最关键:tool / skill / hook 三选一 |
entry | 入口文件,相对插件根目录 |
kind 决定了这个插件干什么活:
| kind | 做什么 | 注册方式 |
|---|---|---|
tool | 给 Agent 增加一个可以调用的工具 | ctx.tool(...) |
skill | 把一份 SKILL.md 同步进 Agent 工作区 | ctx.skills("skills") |
hook | 插到对话生命周期的中间件链上 | ctx.middleware(...) |
动手:一个统计字数的插件
需求很简单:Agent 写中文的时候,让它能自己查一段话有多少字、其中汉字多少。
my-first-plugin/plugin.yaml
id: my-first-plugin
version: 0.1.0
name: My First Plugin
description: 统计文本字数(区分汉字与英文词)
icon: "🔢"
group: tools
kind: tool
entry: main.py
my-first-plugin/main.py
from __future__ import annotations

from octop_harness.plugins import PluginContext


async def count_text(text: str) -> str:
    """统计一段文本的总字符数、汉字数与英文词数。"""
    cjk = sum(1 for ch in text if "\u4e00" <= ch <= "\u9fff")
    words = len([w for w in text.split() if w])
    return f"总字符 {len(text)},汉字 {cjk},英文词 {words}"


def setup(ctx: PluginContext) -> None:
    ctx.tool(
        "count_text",
        count_text,
        description="统计文本的字符数、汉字数与英文词数",
    )
就这么多,二十行。
原理:三个环节,全在进程内
第一环,发现和加载。 服务启动时 PluginManager 会扫 ~/.octop/plugins/*(以及内置的那些,默认不启用),读 plugin.yaml,把列表呈现给管理页。这就是你在页面上看到的「已安装 / 已加载」两种状态——文件在磁盘上叫已安装,import 成功了才叫已加载。所以我装完必须点一次「重新加载」,否则状态是 not loaded。
第二环,setup(ctx) 把能力挂上去。 入口文件被 import 后,框架只调一个函数:setup(ctx)。你在里面调 ctx.tool(...),把「名字 + 函数 + 描述」登记进去。PluginContext 就是框架给你的手柄,tool / skills / middleware 三选一或组合用。
第三环,函数签名被投影成工具 schema。 这一步是整个设计最省事的地方:你不需要写 JSON Schema。框架读你函数的参数名、类型注解和 docstring,生成给大模型看的 function calling 声明。所以我上面那个 text: str 就自动变成了一个必填的 string 参数;如果把注解改成 tz: str = "UTC",它就变成可选参数、默认 UTC。
换句话说:函数签名就是协议。你写 Python 类型注解,等于在写工具的接口定义。
如果要给运营留一个「界面可配」的参数(避免每个 Agent 都改代码),用 config_fields 加 get_tool_config:
from octop_harness.plugins import PluginContext, get_tool_config


async def echo_with_prefix(message: str) -> str:
    cfg = get_tool_config("echo_with_prefix") or {}
    prefix = str(cfg.get("prefix") or "")
    return f"{prefix}{message}"


def setup(ctx: PluginContext) -> None:
    ctx.tool(
        "echo_with_prefix",
        echo_with_prefix,
        description="给消息加一个可配置的前缀后回显",
        config_fields=[{"name": "prefix", "type": "text", "required": False}],
    )
prefix 不会出现在模型的参数列表里——它是每个 Agent 各自的配置项,在「个性化 → 工具」里填。这个区分很重要:给模型看的(参数)和给人配的(config)要分开,否则模型会自作主张传一个前缀进来。
另外两种 kind 也顺带说一下:skill 型插件不注册工具,setup 里只写 ctx.skills("skills"),框架在 Agent 启动时把 skills/<名字>/SKILL.md 同步进它的工作区——改的是提示词侧,不是代码侧;hook 型插件用 ctx.middleware(...) 挂到对话生命周期上,适合做审计、敏感词、上下文注入这类横切逻辑。
打包、安装、启用
# 打包:zip 根目录下必须能直接看到 plugin.yaml
zip -r my-first-plugin.zip my-first-plugin/

# 安装(也可以在网页「从 ZIP 安装」)
octop plugin install ./my-first-plugin.zip
octop plugin list
# - my-first-plugin v0.1.0 (tool) [not loaded]

# 让运行中的服务加载它
curl -X POST http://127.0.0.1:8088/api/plugins/reload
装完在管理页看到的就是这个样子:
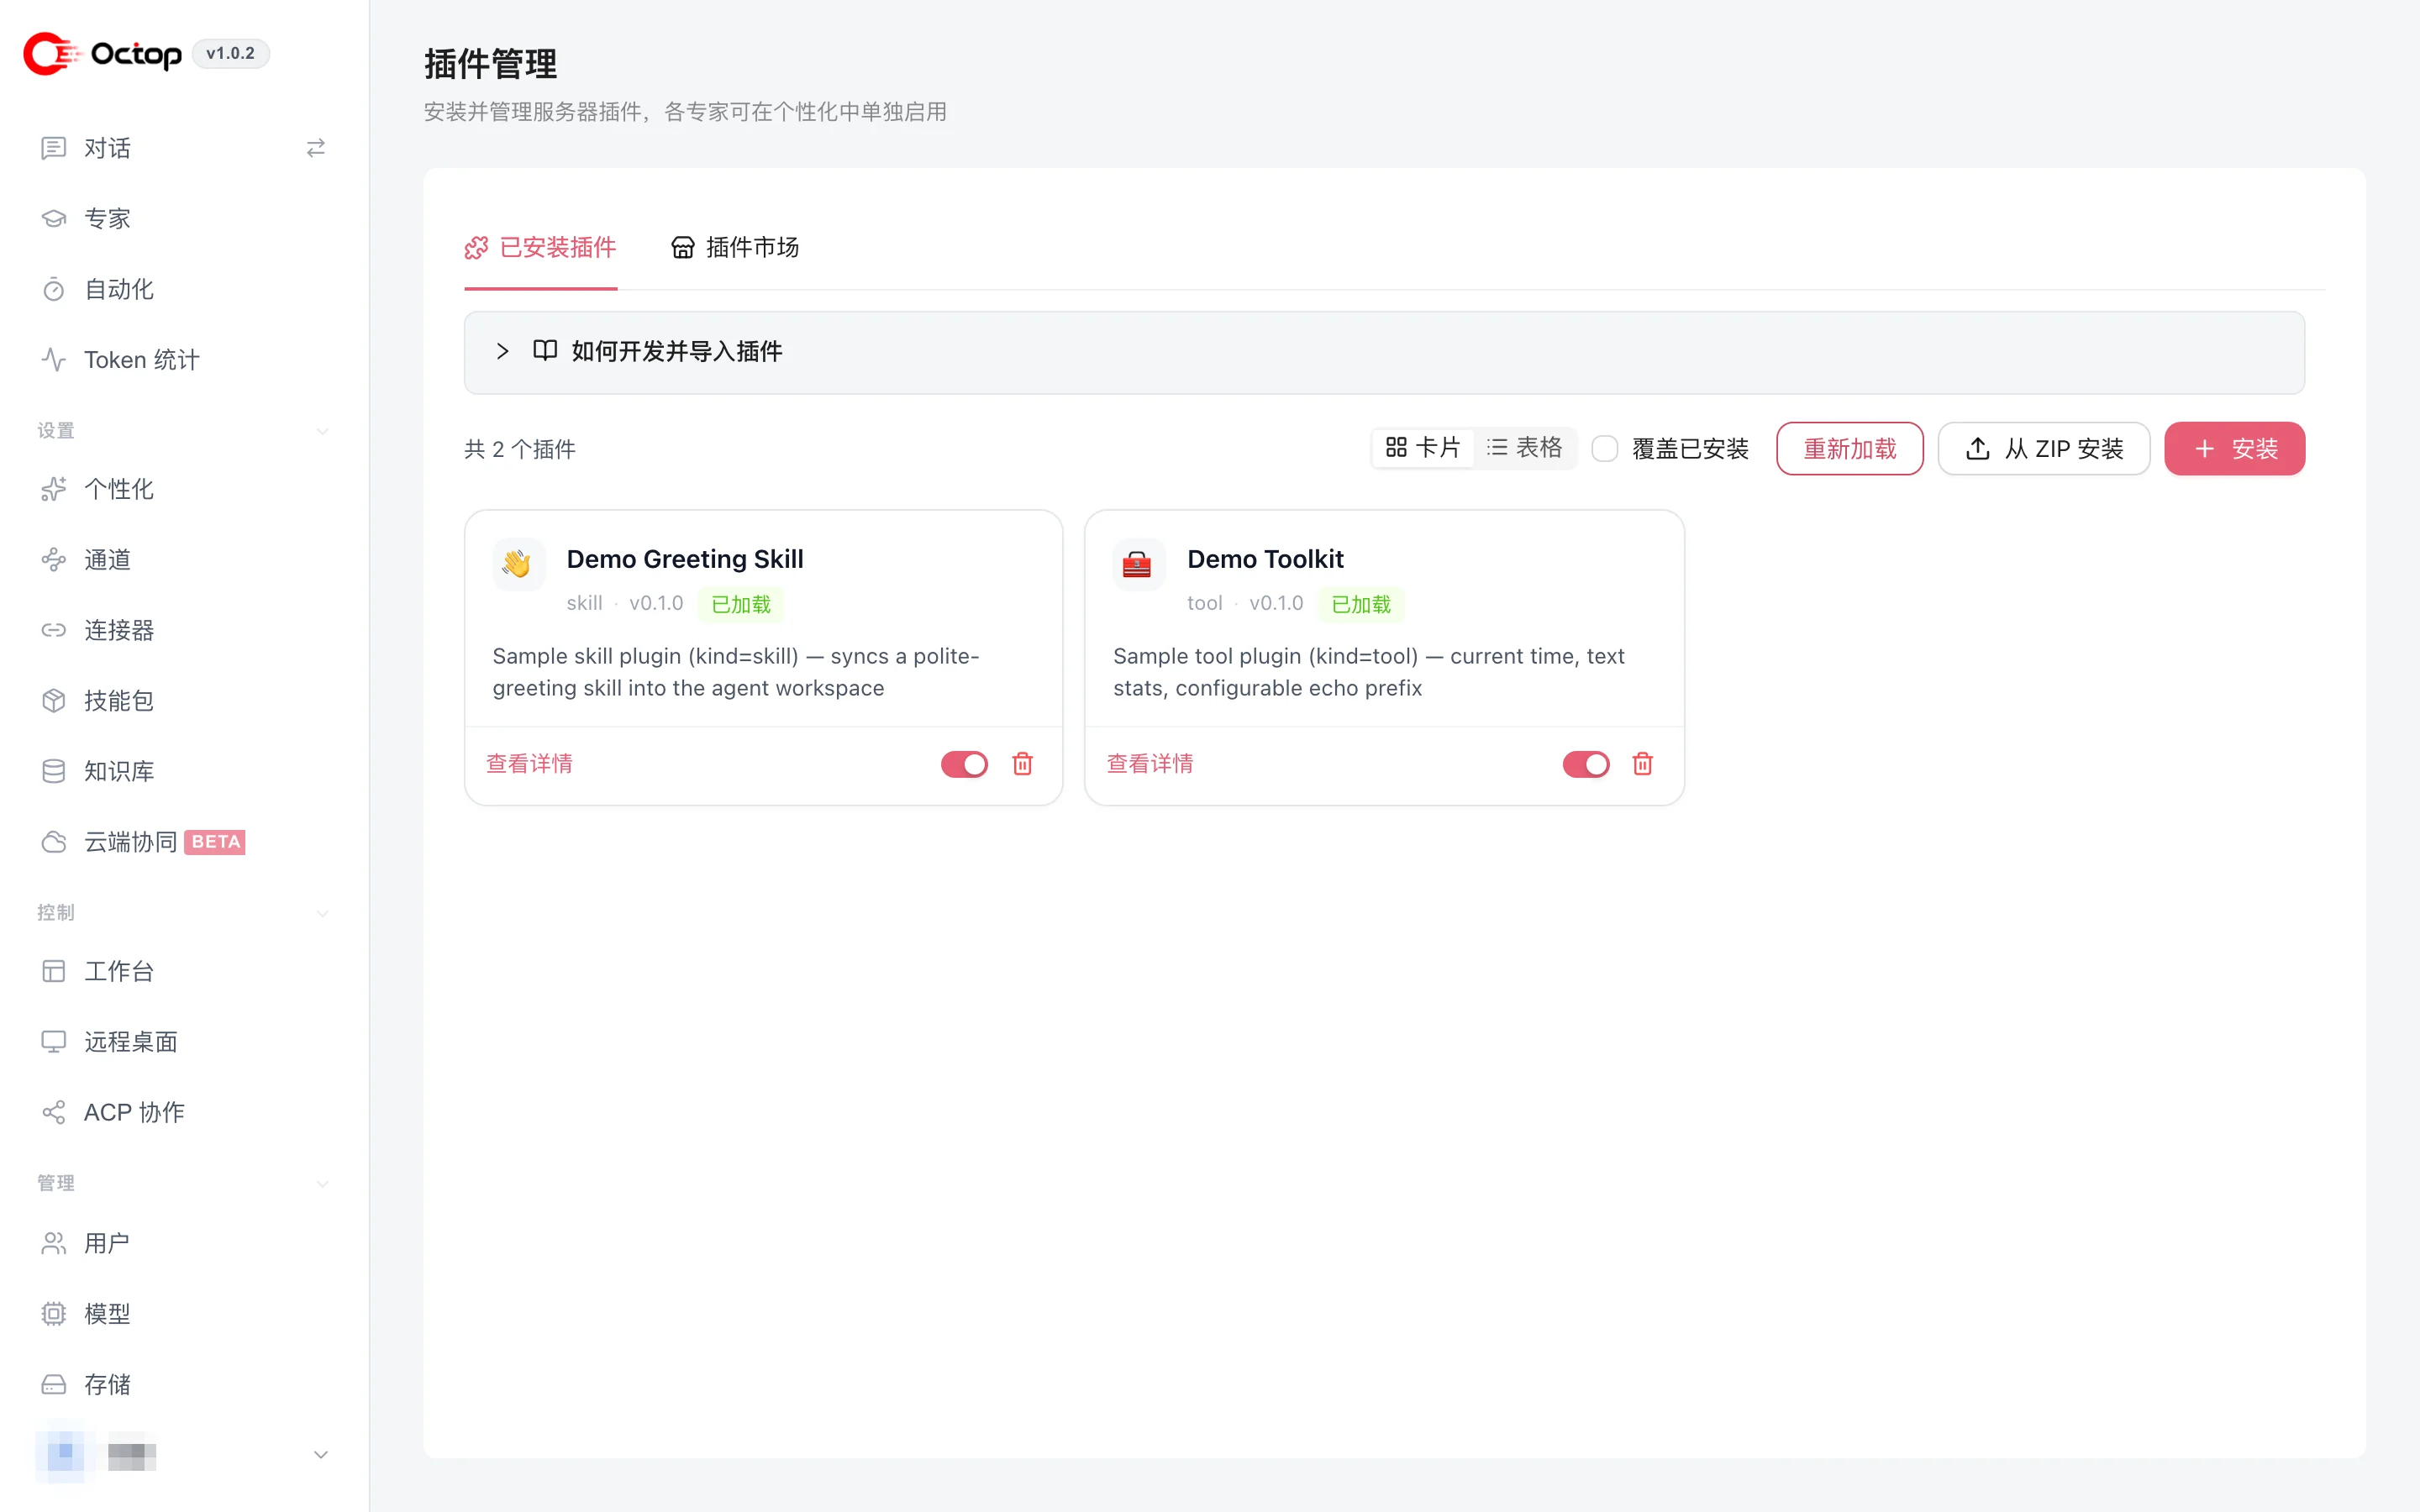
然后我们就可以在对话中使用
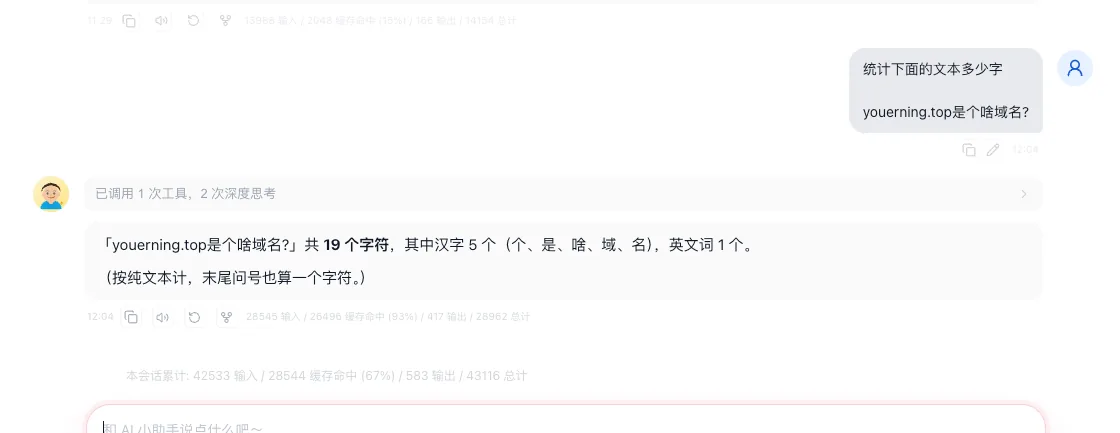
以为我们在描述中已经说了,这个工具的作用是统计字数,所以我们在使用下面的提示词时,他就会调用对于的工具。
统计下面的文本多少字

youerning.top是个啥域名?
最后一步别忘了:插件是全局装的,但要在「个性化 → 插件」里按专家启用。装完直接在对话里问,它还是不会用——这是设计如此,不是 bug。
备份、升级、迁移
octop backup create                 # 生成 tar.gz:数据库 + 工作区 + 配置
octop backup auto status            # 看自动备份(默认每天 04:00)
octop backup restore <归档文件>      # 恢复,要求先停服
最省事的冷备,直接拷目录:
octop service stop
cp -a ~/.octop ~/octop-backup-$(date +%F)
octop service start
升级:
octop update --check                # 看有没有新版
octop backup create                 # 先备份,永远先备份
uv pip install -U octop
octop service restart
迁移到别的机器:拷走 ~/.octop,用同样的 OCTOP_HOME 起服务就行,不用重装数据库、不用导表。这就是把数据目录集中在一个地方的好处。
五条安全红线
下面是AI对于代码的一些安全建议,仅供参考,我还没有细致的阅读本项目的代码。
1. 供应商的 API Key 对任何登录用户都是明文返回的。
api/routers/providers.py 第 249 行,列表接口的依赖只是 Depends(current_user)(普通用户即可),而 _row_to_dict() 里 "api_key": r.api_key 是原样拼进去的。也就是说,只要你给别人开了号,他打开开发者工具就能看到你的 Key。
一个人用无所谓;要开号,先把这行改成脱敏返回,或者干脆把 Key 收进环境变量、库里只存引用。
2. 文件浏览默认从 / 开始,终端用的是同一个 OS 用户。
应用层的「隔离」不等于系统层的隔离。Agent 的用户目录隔离开了,但只要它能起终端、能浏览文件,实际权限就是这个进程的权限。多人场景要么给每个用户配 workspace_root_dir,要么直接容器化,把根目录限死在容器里。
3. token_quota 和 max_agents 默认不限。
一个人跑没事,开了号就是「谁都能把我的额度跑光」。给自己定个规矩:加用户的同时就把这两个数填上。
4. 监听 0.0.0.0 意味着同网段谁都能访问。
局域网里跑图省事,但别把端口映射到公网就直接用。要在公网用,前面至少加一层 HTTPS 反代,并且把管理员密码换成强口令。
5. 插件是进程内的 Python 代码,没有沙箱。
setup(ctx) 里你想干什么都行——读文件、发请求、起线程。所以只装你自己写的或你信任的插件,这一点和给 VSCode 装扩展是一个道理,但权限更大,因为它跑在服务端。
排障速查
| 现象 | 先看这里 |
|---|---|
| 页面打不开 | octop service status;lsof -nP -iTCP:8088 -sTCP:LISTEN |
| 启动就退出 | $OCTOP_HOME/logs/octop.log 尾部 |
| 反复重启 | launchctl print gui/$(id -u)/octop | grep "last exit"(macOS) |
| 对话报「没有模型」 | octop models active,大概率是没设默认模型 |
| 改了配置没生效 | 绝大多数配置要重启服务 |
| 局域网连不上 | 确认同网段;换过 Wi-Fi 重新查 IP |
| 插件装了没反应 | 管理页状态是不是 not loaded;以及有没有在「个性化 → 插件」里对这个专家启用 |
| 定时任务没跑 | 那个 Agent 有模型吗、有权限吗、工作区脚本还在吗 |
| 密码忘了 | octop user passwd <用户名> |
| 想彻底重来 | octop clean(会删 ~/.octop,先备份) |
小结
我把能复用的东西压成了一份清单:
- 数据全在
OCTOP_HOME一个目录——备份、迁移、清空都围绕它,这是整套设计里最省心的约定。 - 装完先配模型再看别的,
octop models active是判断「能不能聊」的唯一标准。没有大脑,AGENT工具啥都不是(基本上)。 - 隔离粒度是 Agent 不是用户;
shared共享的是工作区,不是对话。 - 给同事开号之前:先改掉明文返回 Key 的问题,设上
token_quota和max_agents。 - 写插件的顺序:
plugin.yaml定 kind → entry 里写setup(ctx)→ 函数签名当接口 → 打包 zip → 装完 reload → 按专家启用。 - 插件跑在服务端进程里,权限等同服务本身,别乱装。
它适合什么场景?我自己的判断是:当你需要一个「在服务器上持续活着、能从 IM 里被叫到、还能碰文件和终端」的助手,并且不止你一个人要用——这时候 Octop 的形态是贴合的。如果只是自己写代码想有个结对伙伴,一个 CLI 工具更轻。
比如下面的场景,你做了一堆的项目skill,mcp以及需要一些代码能力才能使用的功能,如果让同事(这里特指没有技术背景的同事)使用自己的工具,比如workbuddy,那么环境不太好统一,你去帮他配置又非常费时间,那么一套支持多用户可以自己托管的“开源workbuddy”就非常好用,我就是基于这个场景才入坑的,希望这个项目可以健康发展。
下一篇我会开始拆它的源码。
参考链接
- 官方仓库与中文 README:https://github.com/TencentCloud/Octop
- 三个可复用的库:https://github.com/TencentCloud/octop-harness(LangGraph 运行时)、https://github.com/TencentCloud/octop-gateway(IM 管道)、https://github.com/TencentCloud/octop-memory
- https://docs.astral.sh/uv/
- 架构说明:仓库内
docs/architecture.md - CLI 全量命令:仓库内
docs/cli.md - 配置项:仓库内
docs/configuration.md - LDAP / SSO:仓库内
docs/ldap.md - 插件开发规范:仓库内
plugins/README_CN.md,以及管理页「如何开发并导入插件」折叠面板 - Docker 部署:仓库内
docker/(含 PostgreSQL 与国内镜像两份 compose)
